

Zusammenfassung & wichtigste Erkenntnisse
Im Jahr 2026 hat sich die KI-Sicherheitsstrategie von Unternehmen von der reaktiven Erkennung von Schatten-KI hin zur aktiven, transaktionsbezogenen Governance autonomer KI-Agenten verlagert. Die schnelle Verbreitung agentischer KI hat zusammen mit der breiten Einführung des Model Context Protocol (MCP) zur Verbindung interner Datenspeicher mit externen Modellen die Risikofläche von Unternehmen über die einfache, Prompt-basierte Datenexfiltration hinaus erweitert. Dieser Bericht analysiert die daraus resultierende KI-Sicherheitslandschaft, beschreibt operative Risiken, die von nachgelagerten Datenschutzrichtlinienverletzungen bis zur autonomen Ausführung schädlichen Codes reichen, und begründet die technische Notwendigkeit einer Inspektion des KI-Datenverkehrs und einer Zero-Trust-KI-Architektur. Zu den wichtigsten Erkenntnissen dieses Berichts gehören:
- Datensicherheitsrisiken: Ein starker Anstieg nachgelagerter Datenschutzrichtlinienverletzungen Nachgelagerte Datenschutzrichtlinienverletzungen, bei denen ein KI-Dienst sensible Daten zurückgibt, auf die ein Benutzer oder Agent nicht zugreifen darf, nehmen stark zu. Grund dafür ist ein vierfacher Anstieg des MCP-Datenverkehrs, da Unternehmen ihre KI-Systeme weiterhin mit sensiblen Datenspeichern verbinden.
- Agentische Risiken: Der operative Wandel hin zum autonomen Coding Ein starker Anstieg bei der Nutzung von Coding-Agenten führt zu einem höheren KI-Datenverkehrsvolumen, einer stärkeren MCP-Vernetzung und erhöhten Risiken durch die Ausführung schädlichen Codes. Heute nutzen 75 % der Unternehmen Claude Code und 58 % Codex – ein dramatischer Anstieg gegenüber einer nahezu nicht vorhandenen Einführung vor einem Jahr.
- Adversariale Risiken: Schädlicher Code, Links und Köder Mit zunehmender KI-Einführung verwenden Angreifer weiterhin KI-Köder, um Opfer zum Herunterladen von Malware oder zum Besuch schädlicher Webseiten zu verleiten. Gleichzeitig werden Angreifer immer geschickter darin, KI-Apps selbst dazu zu bringen, ihren Opfern schädlichen Code anzuzeigen. Dadurch steigt das Risiko, dass autonome Coding-Agenten solchen Code ausführen oder ihn in umfangreichere Codebasen integrieren.
Einführung
Mit der zunehmenden Reife der Einführung von generative KI in Unternehmen hat sich der Schwerpunkt der Sicherheitsverantwortlichen von der anfänglichen Herausforderung der Erkennung von Schatten-KI hin zur komplexeren Anforderung einer granularen, transaktionsbezogenen Governance verlagert. Eine effektive Governance verlangt nun von Sicherheitsteams, über Richtlinien hinauszugehen, die sich primär auf die Begrenzung des Datenflusses zu KI-Plattformen von Drittanbietern konzentrieren. Stattdessen müssen sie ein strukturiertes Framework zur Risikobewertung einführen, das KI-Interaktionen anhand von vier kritischen Dimensionen bewertet: Volumen, Richtung, Schweregrad und Absicht.
Die Bedrohungslandschaft für Unternehmen hat sich grundlegend verändert, da dieselben Tools, die Produktivität ermöglichen – KI-Chatbots, KI-Assistenten, autonome KI-Agenten, MCP-Server usw. – gleichzeitig die Angriffsfläche vergrößern. Während vorgelagerte Datenschutzrichtlinienverletzungen, bei denen Benutzer und Agenten sensible Daten unter Verstoß gegen Unternehmensrichtlinien an Dritte senden, weiterhin die häufigste Fehlerquelle darstellen, nehmen kritische adversariale Risiken wie Prompt Injection, Jailbreaking und die nachgelagerte Ausführung schädlichen Codes zu. Gleiches gilt für nachgelagerte Datenschutzrichtlinienverletzungen, die aus der zunehmenden Vernetzung von KI-Systemen resultieren. Dieser Bericht bietet einen granularen Überblick über die KI-Risikolandschaft in Unternehmen und die technische Grundlage für die Implementierung der Transparenz, Governance und des Schutzes, die zur angemessenen Absicherung von KI-Bereitstellungen in Unternehmen erforderlich sind.
Kategorisierung von KI-Risiken
Transparenz, Governance und Schutz im Bereich KI beginnen mit einem Verständnis der aktuellen Risikolandschaft. Das folgende Diagramm ordnet die am weitesten verbreiteten Risiken nach der Häufigkeit der in Unternehmen beobachteten Verstöße. An der Spitze dieser Liste stehen vorgelagerte Datenschutzrichtlinienverletzungen, auf die früher nahezu 100 % der Warnmeldungen entfielen, deren Anteil jedoch unter 90 % gefallen ist, da das Volumen anderer Arten von Verstößen zugenommen hat. Am anderen Ende des Spektrums befinden sich Verstöße durch schädlichen Code, bei denen ein KI-System schädlichen Code zurückgibt. Sie treten am seltensten auf, haben aber zugleich den höchsten Schweregrad.
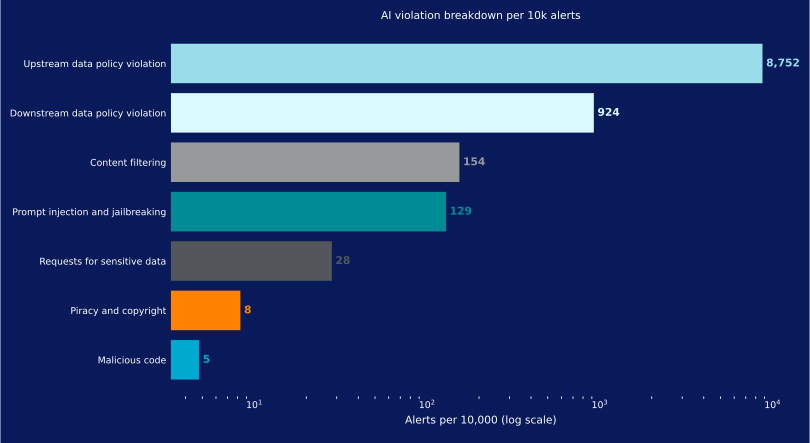
In der folgenden Liste untersuchen wir jedes dieser Risiken ausführlicher, einschließlich Richtung, Absicht und Schweregrad.
Vorgelagerte Datenschutzrichtlinienverletzung
Richtung: Vorgelagert
Absichtsprofil: Insider/Produktivität/Fahrlässigkeit
Schweregrad: Kumulativ
Was ist eine vorgelagerte Datenschutzrichtlinienverletzung?
Das häufigste KI-Risiko besteht darin, dass ein Benutzer oder Agent versucht, Daten unter Verstoß gegen die Datennutzungsrichtlinien des Unternehmens an ein KI-System zu senden. Dazu gehört das Senden vertraulicher Informationen oder von Quellcode an nicht genehmigte Dienste. Unternehmen verwenden solche Richtlinien in der Regel, um ihre Benutzer von Schatten-KI weg und hin zu genehmigten KI-Diensten zu führen sowie Anwendungsfälle den geeigneten Diensten zuzuordnen. Beispielsweise könnten einige KI-Dienste ausschließlich für Coding- und Entwicklungsaufgaben autorisiert sein, während andere nur zur Verarbeitung sensibler Daten in Dokumenten und Tabellen zugelassen sind. Datenschutzrichtlinienverletzungen gehen in erster Linie von vertrauenswürdigen Insidern aus, die ihre Produktivität steigern möchten, dabei jedoch fahrlässig handeln, weil ihnen die Unternehmensrichtlinien nicht bekannt sind. Der Schweregrad des Risikos ist hier kumulativ, da eine kontinuierliche Offenlegung sensibler Daten gegenüber Dritten zu Compliance- oder regulatorischer Haftung führen kann.
Nachgelagerte Datenschutzrichtlinienverletzung
Richtung: Nachgelagert
Absichtsprofil: Insider/Produktivität/Fahrlässigkeit
Schweregrad: Niedrig/moderat
Was ist eine nachgelagerte Datenschutzrichtlinienverletzung?
Nachgelagerte Datenschutzrichtlinienverletzungen treten auf, wenn ein KI-Dienst Daten zurückgibt, auf die der Benutzer oder Agent gemäß den Unternehmensrichtlinien nicht zugreifen darf. Solche Verstöße entstehen, wenn ein Unternehmen MCP, Retrieval-Augmented Generation (RAG) oder angepasste Modelle verwendet, die mit proprietären Daten trainiert wurden. In diesen Fällen könnte eine KI-App sensible Daten aus einem verbundenen System zurückgeben, auf die der Benutzer oder Agent nicht zugreifen darf. Ein weiteres, selteneres Beispiel für eine nachgelagerte Datenschutzrichtlinienverletzung liegt vor, wenn ein Unternehmen eine App autorisiert, ihre Nutzung jedoch auf einen bestimmten Anwendungsfall beschränkt. Benutzer und Agenten könnten die App beispielsweise als universellen Chatbot verwenden dürfen, nicht jedoch zur Generierung von Quellcode. Jeder von der App zurückgegebene Quellcode würde als nachgelagerter Verstoß klassifiziert. Wie bei vorgelagerten Verstößen ist das primäre Absichtsprofil bei nachgelagerten Verstößen ein vertrauenswürdiger Insider, der durch Produktivitätssteigerungen motiviert ist. Der Schweregrad des Risikos hängt von der Art der Daten und dem Umfang des Zugriffs ab.
Inhaltsfilterung
Richtung: Bidirektional
Absichtsprofil: Insider/Verhalten
Schweregrad: Niedrig
Was ist Inhaltsfilterung im Kontext von KI-Risiken? Verstöße gegen die Inhaltsfilterung sind bidirektional und treten auf, wenn ein Benutzer oder Agent einen Prompt an ein KI-System sendet oder eine Antwort von diesem erhält, die Inhalte enthält, welche gemäß den Unternehmensrichtlinien als unangemessen gelten. Diese Arten von Verstößen ähneln Verstößen gegen die URL-Filterung eines Secure Web Gateway (SWG): Ebenso wie Unternehmen sexuelle oder gewalttätige Inhalte im Web blockieren, verhindern sie in der Regel auch, dass KI-Apps solche Inhalte zurückgeben. Verstöße gegen die Inhaltsfilterung haben einen niedrigen Schweregrad, da sie eine minimale Bedrohung für das Netzwerk oder die Datenbestände des Unternehmens darstellen. Stattdessen handelt es sich in erster Linie um Themen aus den Bereichen Personalwesen, rechtliche Compliance oder kulturelle Ausrichtung.
Prompt Injection und Jailbreaking
Richtung: Bidirektional
Absichtsprofil: Adversarial/Umgehung\
Schweregrad: Kritisch
Was ist Prompt Injection? Was ist Jailbreaking? Verstöße durch Prompt Injection und Jailbreaking treten auf, wenn ein Benutzer oder Agent versucht, Schutzmechanismen zu umgehen, zugrunde liegende Systemanweisungen zu unterlaufen oder ein KI-System anderweitig zur Ausführung einer eingeschränkten Aktion zu zwingen. Solche Verstöße resultieren aus bewussten adversarialen Handlungen oder Umgehungsversuchen durch einen Insider oder externen Angreifer. In vielen Fällen handelt es sich um indirekte Prompt-Injection-Angriffe, bei denen ein Angreifer schädliche Anweisungen in externe Datenquellen einbettet, auf die ein KI-System zugreift. Der Schweregrad ist kritisch, da eine erfolgreiche Ausnutzung die Steuerungsebene des Modells unterwandert und potenziell kaskadierende Ausführungspfade über verbundene Backend-Dienste hinweg auslöst.
Anfragen nach sensiblen Daten
Richtung: Vorgelagert
Absichtsprofil: Adversarial/Aufklärung/Sammlung
Schweregrad: Hoch
Was sind Anfragen nach sensiblen Daten im Kontext von KI-Risiken? Anfragen nach sensiblen Daten sind vorgelagerte Verstöße, die auftreten, wenn ein Benutzer oder Agent Anzeichen dafür zeigt, dass er bewusst versucht, Steuerungen zu umgehen, um auf diese Daten zuzugreifen. Der Schweregrad eines solchen Verstoßes ist aufgrund des unterschiedlichen Absichtsprofils im Allgemeinen höher als der einer nachgelagerten Datenschutzrichtlinienverletzung. Eine nachgelagerte Datenschutzrichtlinienverletzung kann ohne gezielte Aufforderung auftreten, nur weil das System Zugriff auf Daten hat, auf die der Benutzer nicht zugreifen darf. Im Gegensatz dazu weisen Anfragen nach sensiblen Daten darauf hin, dass der Anfragende beabsichtigt, auf solche Daten zuzugreifen. Anfragen nach sensiblen Daten in Kombination mit nachgelagerten Datenschutzrichtlinienverletzungen weisen auf ein kritisches Risiko hin, da sie nahelegen, dass der Anfragende mit seinen Bemühungen Erfolg hat.
Piraterie und Urheberrecht
Richtung: Nachgelagert
Absichtsprofil: Compliance/versehentlich
Schweregrad: Niedrig
Welche Urheberrechtsrisiken sind mit KI verbunden? Ein Verstoß im Zusammenhang mit Piraterie und Urheberrecht ist ein nachgelagerter Verstoß, der auftritt, wenn eine KI-Anwendung geschütztes, urheberrechtlich geschütztes oder markenrechtlich geschütztes Material ohne gültige Drittanbieterlizenz oder Genehmigungsnachweis zurückgibt. Solches Material stellt bei unsachgemäßer Verwendung ein rechtliches und finanzielles Risiko für das Unternehmen dar. Es stellt jedoch eine minimale Bedrohung für das Netzwerk oder die Datenbestände des Unternehmens dar und gilt daher als geringes Risiko.
Schädlicher Code
Richtung: Nachgelagert
Absichtsprofil: Adversarial/Waffenentwicklung
Schweregrad: Kritisch
Was ist schädlicher Code im KI-Kontext? Ein Verstoß durch schädlichen Code tritt auf, wenn eine KI-Anwendung in ihrer Antwort schädlichen Code zurückgibt. Bei dem schädlichen Code kann es sich um Shell-Befehle handeln, die ein Benutzer oder Agent direkt ausführen könnte, oder um ein schädliches Codefragment, das in eine umfangreichere Codebasis integriert wird. Autonome Coding-Agenten, die schnell an Beliebtheit gewinnen, verstärken dieses Risiko, da sie Code erheblich schneller als Menschen generieren und KI-generierten Code sowie Befehle autonom ausführen. Eine KI-App kann schädlichen Code infolge einer indirekten Prompt Injection, trojanisierter KI-Tools oder Modelle oder sogar auf organische Weise zurückgeben. Organisch entstandener schädlicher Code kann durch das Training mit anfälligen Daten, emergente Fehlausrichtung oder Halluzination zurückgegeben werden. Der Schweregrad ist kritisch, da die erfolgreiche Ausführung schädlichen Codes zu einer weitreichenden Kompromittierung von Systemen führen kann. Verstöße durch schädlichen Code in Verbindung mit Verstößen durch Prompt Injection und Jailbreaking machen die Absicht sichtbar und weisen auf einen möglichen Erfolg hin.
KI-Einführung: Anhaltendes Wachstum
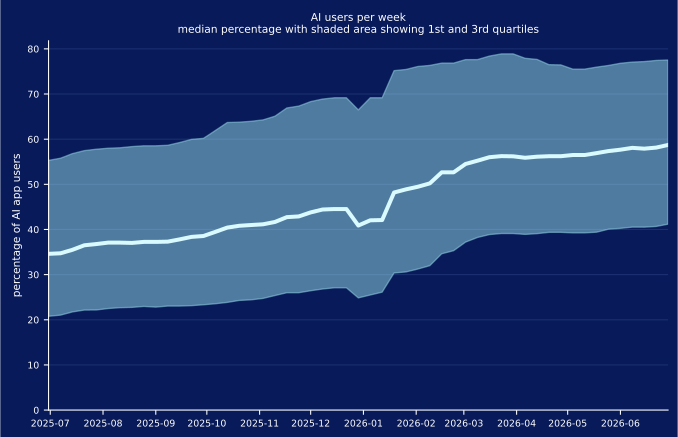
Im vergangenen Jahr ist der Anteil der Unternehmensbenutzer, die wöchentlich aktiv KI-Apps verwenden, im Medianunternehmen von 34 % auf 59 % gestiegen. Im obersten Quartil der Unternehmen interagieren jede Woche mindestens 77 % der Benutzerbasis mit KI-Apps. Unterdessen haben die obersten 1 % der Unternehmen mit den meisten KI-Benutzern, die nicht dargestellt sind, bereits ein Plateau von nahezu 100 % erreicht. Der Rückgang in der Darstellung Ende 2025 und Anfang 2026 ist ein Artefakt, das im gesamten Bericht auftritt und aus der insgesamt geringeren Aktivität während der Feiertage resultiert. Die Geschwindigkeit der KI-Einführung nahm Ende 2025 leicht zu, und dieses beschleunigte Wachstum setzte sich bis Anfang 2026 fort, hat sich seitdem jedoch verlangsamt. Wir erwarten, dass dieses Wachstum in der zweiten Jahreshälfte 2026 ein Plateau erreicht, da Unternehmen bei ihren KI-Investitionen strategischer vorgehen.
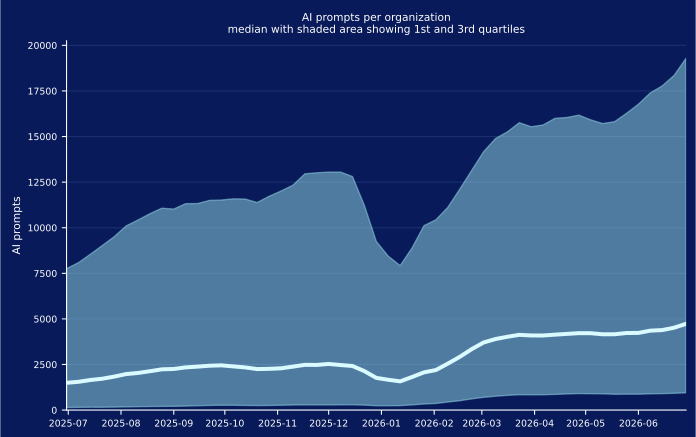
Gleichzeitig hat sich das Volumen der KI-Nutzung verdreifacht – von durchschnittlich 1.498 auf 4.731 Prompts pro Woche. Die obersten 25 % der Unternehmen verzeichneten mit mindestens 19.292 Prompts ein deutlich höheres wöchentliches Volumen, während die obersten 1 %, die nicht dargestellt sind, Hunderttausende Prompts pro Woche verzeichneten. Dieser Volumenanstieg wird in erster Linie durch die zunehmende Einführung agentischer KI angetrieben, die wir im nächsten Abschnitt ausführlicher untersuchen. Wir erwarten außerdem, dass die Anzahl der Prompts pro Unternehmen in der zweiten Jahreshälfte 2026 ein Plateau erreicht, sobald die Einführung agentischer KI die Sättigung erreicht.
Schatten-KI: Ein Plateau
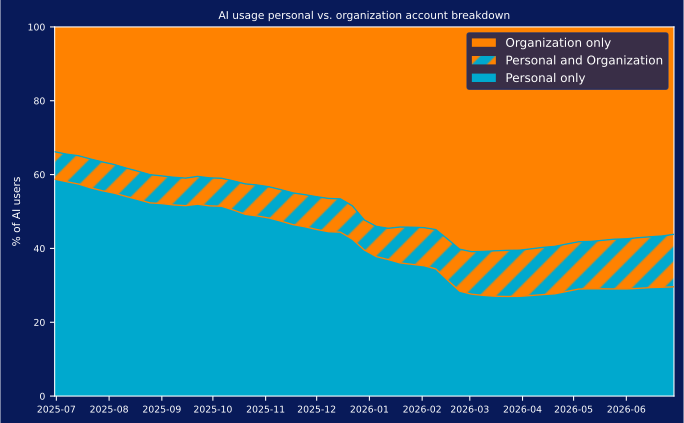
Seit Beginn des KI-Booms beobachten wir eine schrittweise Abkehr von persönlichen, nicht verwalteten Schatten-KI-Apps hin zu unternehmensverwalteten Apps. Im Jahr 2023 war nahezu der gesamte KI-Datenverkehr, den wir in Unternehmen beobachteten, Schatten-KI: Einzelne Benutzer experimentierten mit ihren ChatGPT-Abonnements, um ihre eigene Produktivität zu steigern. Im Laufe der Zeit begannen Unternehmen, genehmigte und verwaltete Apps bereitzustellen, wodurch der Anteil der Benutzer, die auf persönliche KI-Apps zugriffen, zurückging. Dieser Trend endete etwa im März 2026, erreichte ein Plateau und bewegte sich anschließend wieder leicht in die entgegengesetzte Richtung. Derzeit verwenden 56 % der KI-Benutzer ausschließlich unternehmensverwaltete KI-Anwendungen, 14 % verwenden sowohl unternehmensverwaltete als auch persönliche Apps und 30 % verwenden ausschließlich persönliche Apps. Diese Trendumkehr zeigt, dass Schatten-KI dauerhaft bestehen bleibt. Anstatt weiterhin jeden KI-Benutzer und jeden Anwendungsfall auf verwaltete Plattformen zu verlagern, haben Unternehmen sich dafür entschieden, die Nutzung persönlicher und nicht genehmigter Apps mit Schutzmechanismen zu versehen. Gleichzeitig haben sich die Prioritäten bei der Erkennung von Schatten-KI von der Schaffung von Transparenz und der Implementierung von Steuerungen für die Nutzung persönlicher KI-Apps auf KI-Agenten, MCP-Server und lokale KI-Infrastruktur ausgeweitet – alles Bereiche, in denen wir derzeit ein schnelles Wachstum beobachten.
Agentische KI: Ein Coding-Boom
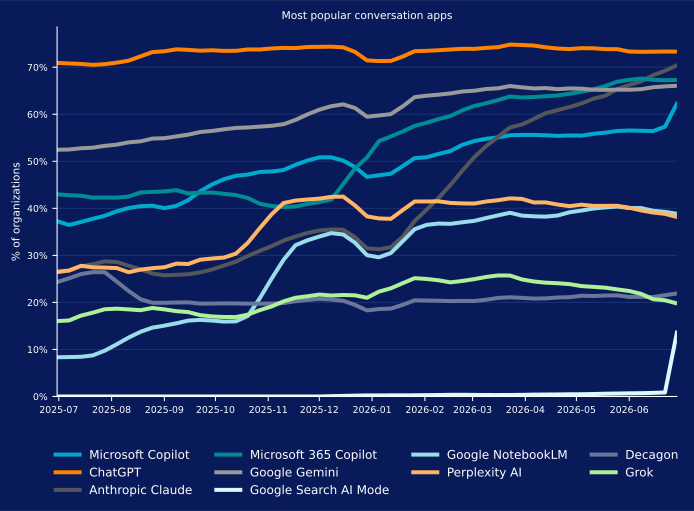
Im vergangenen Jahr hat die Einführung dialogorientierter Chatbot-KI-Apps die Sättigung erreicht. Mehr als 95 % der Unternehmen weltweit verwenden mindestens einmal pro Woche einen Chatbot. ChatGPT, der langjährige Weltmarktführer, bleibt auf dem ersten Platz, wird jedoch von Anthropic Claude, Microsoft 365 Copilot und Google Gemini herausgefordert. Zu Beginn des Jahres lag Google Gemini auf dem zweiten Platz und war auf dem besten Weg, ChatGPT zu überholen, doch seine Einführung erreichte ein Plateau. Microsoft 365 Copilot überholte Google Gemini im Mai, hat jedoch ebenfalls ein Plateau erreicht. Im Juni überholte Anthropic Claude dann beide und gewinnt weiterhin an Beliebtheit. Seine Beliebtheit steht in engem Zusammenhang mit der Einführung von Claude Code, dem Coding-Agenten von Anthropic, den wir später in diesem Abschnitt näher untersuchen. Wenn sich die aktuelle Entwicklung fortsetzt, ist Claude auf dem besten Weg, ChatGPT in der zweiten Jahreshälfte 2026 zu überholen.
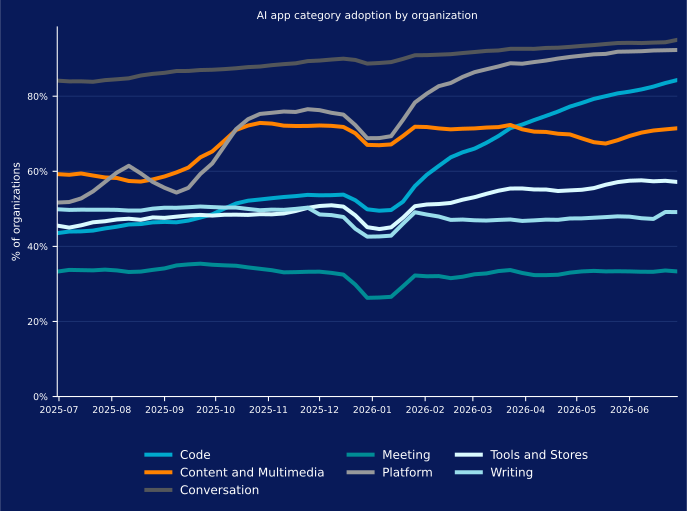
Andere Kategorien von KI-Apps weisen insgesamt niedrigere Einführungsraten auf, die seit Jahresbeginn relativ konstant geblieben sind, mit zwei bemerkenswerten Ausnahmen:
- KI-Code-Apps stellen Tools zur Unterstützung der Softwareentwicklung bereit, darunter das Schreiben, Testen, Debuggen und Optimieren von Code. Agentische Apps zur Codeentwicklung haben die Beliebtheit von Code-Apps von 42 % auf 84 % gesteigert. Obwohl sich die Einführung gegenüber dem schnellen Tempo zu Jahresbeginn verlangsamt hat, dürfte sie in der zweiten Jahreshälfte weiter zunehmen.
- KI-Plattformen optimieren den KI-Entwicklungsprozess, indem sie zentrale Komponenten wie KI-Modelle hosten. Dadurch können sich Entwickler auf die Kernlogik ihrer Anwendungen konzentrieren, ohne die Infrastruktur verwalten zu müssen. Die Einführung von KI-Plattformen ist im vergangenen Jahr schnell von 51 % auf 92 % der Unternehmen gestiegen, hat zuletzt jedoch ein Plateau erreicht. Es wird erwartet, dass die Einführung während der gesamten zweiten Jahreshälfte auf diesem Niveau bleibt.
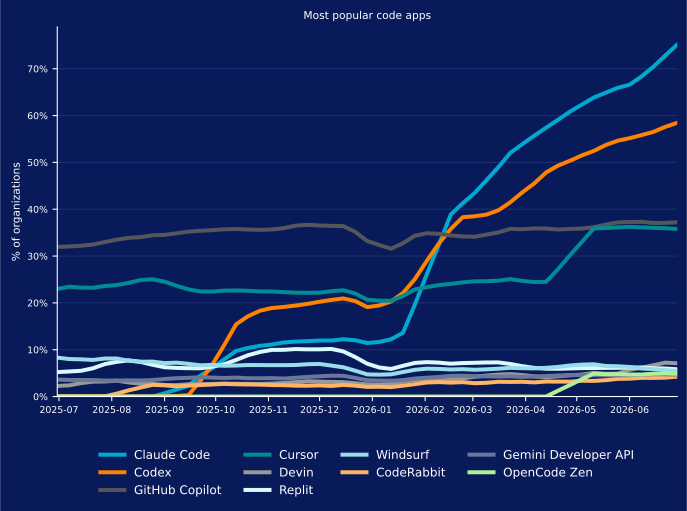
Im Bereich der KI-Code-Apps waren GitHub Copilot und Cursor vor einem Jahr die dominierenden Anbieter. Beide Apps sind KI-gestützte Code-Editoren, die eine traditionelle IDE verwenden und KI-Funktionen zur Unterstützung des Softwareentwicklungsprozesses ergänzen. Während die Beliebtheit dieses Ansatzes offenbar ein Plateau erreicht hat, gewinnen die agentischen Coding-Apps Claude Code und Codex schnell an Beliebtheit. Claude Code ist inzwischen die beliebteste Codeentwicklungsplattform und wird von 75 % der Unternehmen verwendet, gefolgt von Codex auf dem zweiten Platz mit 58 %. Beide Apps hatten vor einem Jahr eine Einführungsrate von weniger als 1 %. Die weiter steigende Beliebtheit dieser beiden Apps unterstreicht den branchenübergreifenden Wandel hin zur agentischen Softwareentwicklung weltweit. Dadurch erhöhen sich bestimmte in diesem Bericht hervorgehobene Risiken, insbesondere diejenigen im Zusammenhang mit Prompt Injection und Jailbreaks, schädlichem Code und dem unsachgemäßen Umgang mit sensiblen Daten.
KI-Plattformen und Datensouveränität
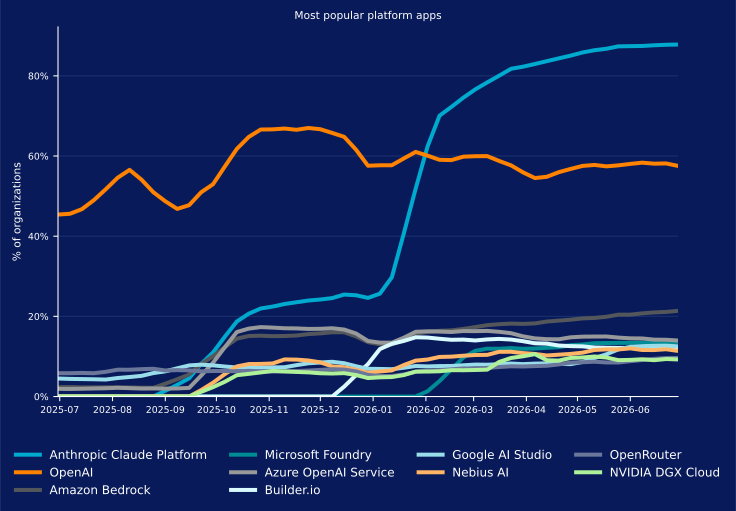
Auch KI-Plattformen gewinnen zunehmend an Beliebtheit, angeführt von der Claude Platform von Anthropic. Wie in diesem Bericht mehrfach hervorgehoben, haben der Claude-Chatbot von Anthropic und Claude Code seit Jahresbeginn schnell an Beliebtheit gewonnen. Die Claude Platform, mit der Benutzer anhand ihrer Modelle benutzerdefinierte Apps und Agenten entwickeln können, verzeichnete ein ähnliches Wachstum und hat die Plattform von OpenAI überholt, die in diesem Bereich einst dominierte.
Gleichzeitig haben mehrere andere Plattformen im Jahresverlauf ein bemerkenswertes Wachstum verzeichnet. Auf einem weit entfernten dritten Platz, aber mit stetig steigender Beliebtheit, liegt beispielsweise Amazon Bedrock. Zu den Gründen, aus denen Bedrock weiterhin an Beliebtheit gewinnt, gehören seine große Modellvielfalt und sein Ansatz zur Datensouveränität. Dieser stellt sicher, dass Unternehmensdaten isoliert und verschlüsselt werden, ausschließlich in den ausgewählten Regionen verarbeitet und niemals an Dritte weitergegeben oder zum Trainieren von Foundation Models verwendet werden. Bestimmte Modelle unterliegen jedoch modellspezifischen Bedingungen. Daher sollten Unternehmen die Nutzung von Plattformen, einschließlich Amazon Bedrock, für jedes einzelne Modell prüfen. Dennoch erwarten wir eine anhaltende Verlagerung hin zu Plattformen wie Bedrock, da Unternehmen der Datensouveränität Priorität einräumen.
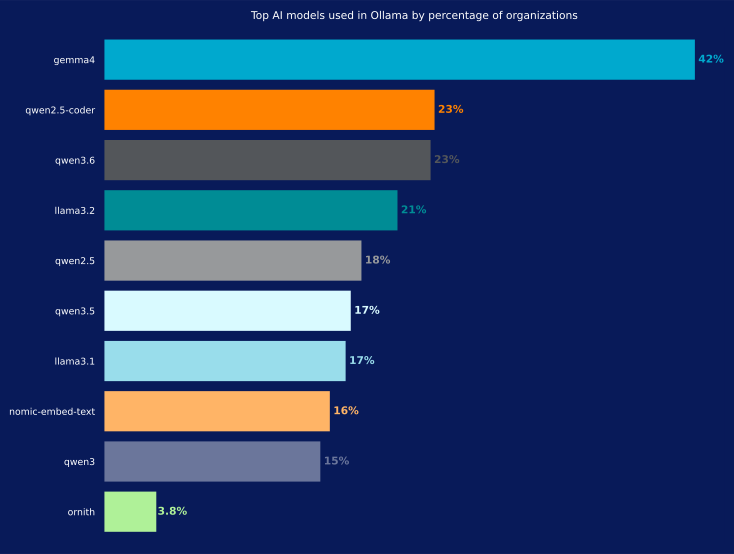
Die lokale Ausführung von Modellen gewinnt an Beliebtheit, da Unternehmen der Datensouveränität zunehmend Priorität einräumen und ihre Cloud-Kosten senken möchten. 41 % der Unternehmen – mehr als Bedrock verwenden, aber weniger als die Plattformen von OpenAI und Claude nutzen – setzen Ollama ein. Dieses beliebte Open-Source-Framework ermöglicht es Unternehmen, Modelle herunterzuladen und lokal auszuführen. Nachfolgend ist die Beliebtheit der Modelle aufgeschlüsselt. Dabei zeigt sich, dass Gemma4 von Google mit großem Abstand am beliebtesten ist, gefolgt von verschiedenen Versionen von Qwen von Alibaba und Llama von Meta. Wir erwarten in der zweiten Jahreshälfte eine deutliche Verschiebung in dieser Rangliste, da die GLM-Modelle von Z.ai derzeit in Benchmarks hervorstechen und an Beliebtheit gewinnen.
MCP: Schnell zunehmende Vernetzung
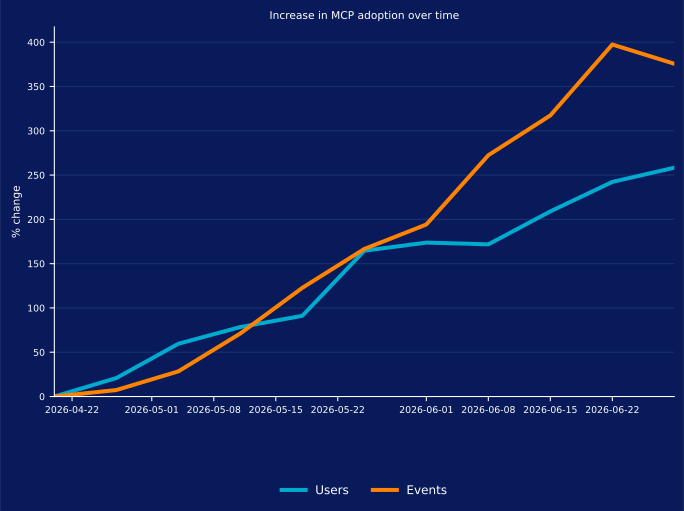
MCP, der Open-Source-Standard zur Verbindung von KI-Modellen mit externen Datenquellen und Tools, hat einen starken Nutzungsanstieg verzeichnet. Allein in den vergangenen zehn Wochen stieg die Zahl der Benutzer um 250 % und die Zahl der Transaktionen um 375 %. Dieser Anstieg ist bedeutsam, da er eine wesentliche Veränderung beim Volumen und bei der Richtung von Datenschutzrichtlinienverletzungen bewirkt, die wir im folgenden Abschnitt untersuchen. Darüber hinaus repräsentieren diese Statistiken ausschließlich die Remote-Nutzung von MCP. Das bedeutet, dass sich der Agent mit einem im Internet gehosteten MCP-Server verbindet und nicht mit einem Server auf dem lokalen Computer oder innerhalb des Unternehmensnetzwerks. Zu den wichtigsten Clients, die für Verbindungen mit diesen MCP-Servern verwendet werden, gehören die bereits zuvor in diesem Bericht erwähnten KI-Coding-Agenten Claude Code und Codex.
Datenschutzrichtlinienverletzungen: Steigendes Volumen
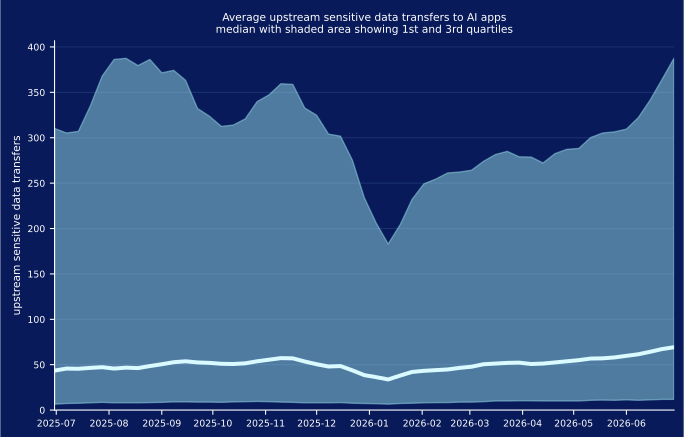
Im vergangenen Jahr hat die Zahl vorgelagerter Datenschutzrichtlinienverletzungen moderat zugenommen. Ein durchschnittliches Unternehmen verzeichnet nun 69 Verstöße pro Woche gegenüber 44 pro Woche vor einem Jahr. Gleichzeitig gab es bei den obersten 25 % der Unternehmen im Jahresverlauf erhebliche Schwankungen. Sie verzeichnen jedoch weiterhin etwa 300 bis 400 Verstöße pro Woche und damit eine ähnliche Größenordnung wie zur gleichen Zeit im Vorjahr.
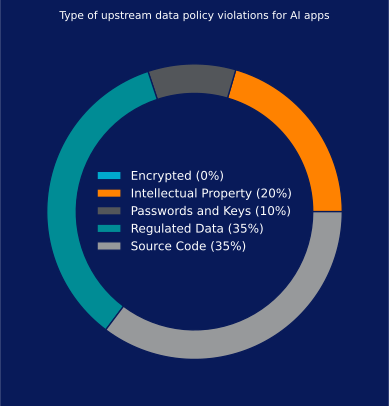
Eine Aufschlüsselung der Arten von Verstößen zeigt, dass geistiges Eigentum, regulierte Daten und Quellcode die überwiegende Mehrheit der Datenschutzrichtlinienverletzungen ausmachen. Ein kleinerer Anteil betrifft Passwörter und Schlüssel, die typischerweise in Quellcode oder Konfigurationsdateien eingebettet sind, welche an KI-Apps gesendet werden.
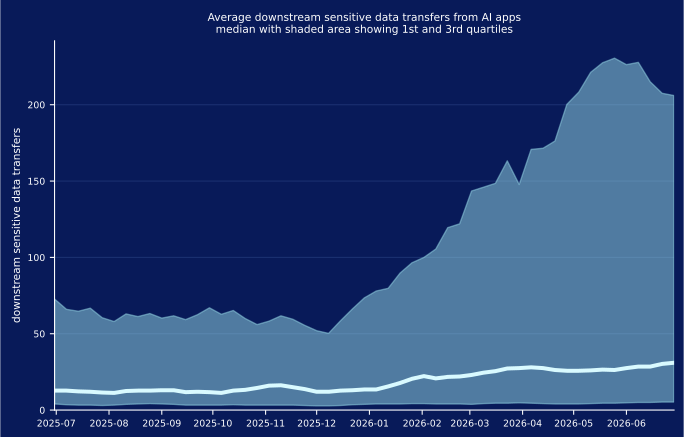
Der Trend bei nachgelagerten Datenschutzrichtlinienverletzungen im vergangenen Jahr unterscheidet sich deutlich von dem bei vorgelagerten Verstößen. Nachgelagerte Verstöße treten seltener auf als vorgelagerte Datenschutzrichtlinienverletzungen, haben sich im vergangenen Jahr jedoch von 12 auf 31 pro Woche mehr als verdoppelt. Bei den obersten 25 % der Unternehmen ist diese Rate von 72 auf 206 pro Woche gestiegen. Dieser Anstieg erfolgt parallel zur zunehmenden Einführung agentischer KI und von MCP, während KI-Apps immer häufiger mit Datenquellen und Tools verbunden werden, die sensible Daten offenlegen. Da die Einführung von MCP weiter zunimmt, erwarten wir, dass der Anteil nachgelagerter Datenschutzrichtlinienverletzungen in der zweiten Jahreshälfte 2026 insgesamt steigen wird.
KI-nahe Bedrohungen
Während sich ein großer Teil dieses Berichts auf neue, KI-native Bedrohungen konzentriert, die höchstwahrscheinlich neue Steuerungen erfordern, muss weiterhin hervorgehoben werden, dass die zunehmende Einführung von KI auch Risiken durch traditionelle, KI-nahe Bedrohungen mit sich bringt. In diesem Abschnitt betrachten wir zwei dieser Bedrohungen: KI-Köder und KI-Links.
Schädliche KI-Köder
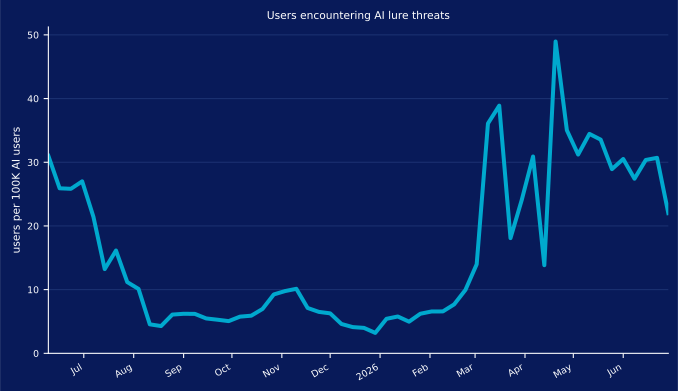
Ein schädlicher KI-Köder versucht, Opfer mithilfe gefälschter Markenauftritte zum Herunterladen von Malware oder zum Besuch einer schädlichen Website zu verleiten. Im vergangenen Jahr beobachteten wir zunächst eine sechsmonatige Flaute bei der Zahl der KI-Köder, bevor sie im März sprunghaft anstieg und bis Juli auf einem ähnlichen Niveau blieb. Zu den jüngsten Kampagnen, die KI-Köder verwenden, gehörten gefälschte Installationsprogramme für KI-Apps und trojanisierte Entwicklertools. Angesichts der anhaltenden Beliebtheit von KI und des Drucks auf Unternehmen, KI zur Steigerung der Produktivität einzusetzen, erwarten wir, dass Angreifer weiterhin ausgefeilte KI-Köder wie diese gefälschten Installationsprogramme entwickeln. Ebenso dürften sie neue Wege finden, um Pipelines für die KI-Softwareentwicklung zu kompromittieren. Dazu gehören weitere Angriffe im Shai-Hulud-Stil und die Erstellung schädlicher Pakete, welche die Namen besetzen, die KI-Modelle häufig halluzinieren.
Schädliche KI-Links
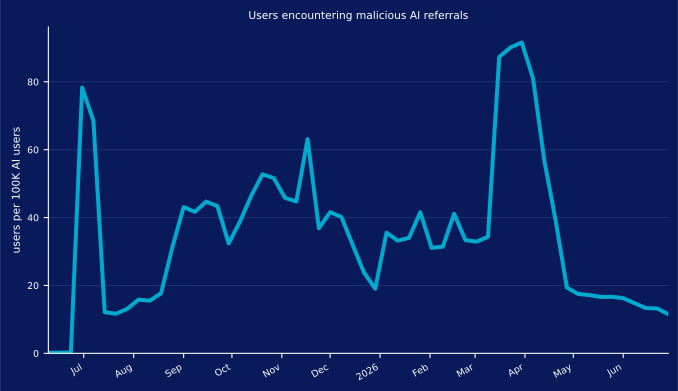
Ein schädlicher KI-Link ist ein schädlicher Link, der von einer KI-App zurückgegeben und von einem Benutzer angeklickt oder von einem Agenten aufgerufen wird. Dies ähnelt einem schädlichen Link, auf den Benutzer bei der Verwendung einer beliebten Suchmaschine wie Bing oder Google klicken. Solche Links erscheinen in den Suchergebnissen, weil der Angreifer entweder SEO-Techniken eingesetzt hat, um seiner schädlichen Website eine hohe Platzierung zu verschaffen, für die Verknüpfung einer schädlichen Anzeige in den Suchergebnissen bezahlt oder anderweitig legitime Infrastruktur kompromittiert hat. In der KI-Welt hat sich die Technologie verändert, die Techniken bleiben jedoch bestehen. AIEO entwickelt sich weiter, da Techniken, mit denen Inhalte von KI-Modellen bevorzugt behandelt werden, allgemein bekannt werden und Anzeigen zunehmend Eingang in KI-Apps finden. Das Volumen dieser Bedrohungen schwankte im Jahresverlauf erheblich – von weniger als 10 bis zu mehr als 90 pro Woche. Trotz der aktuellen Flaute erwarten wir, dass die durchschnittliche Anzahl in der zweiten Jahreshälfte 2026 steigen wird.
Transparenz, Governance und Schutz
Zur Verwaltung von KI-Risiken sollten Unternehmen ihre Sicherheitsstrategien an weithin anerkannten Frameworks wie MITRE ATLAS und den OWASP Top 10 for LLMs ausrichten. Diese Frameworks liefern entscheidenden Kontext: MITRE ATLAS ermöglicht CISOs, die konkret erkannten und blockierten Angriffe einzuordnen, während die OWASP LLM Top 10 Risiken auf Anwendungsebene verdeutlichen. Durch die Integration dieser Frameworks mit Echtzeitüberwachung können Sicherheitsteams die Durchsetzung von Richtlinien effektiv verfolgen, neu auftretende Bedrohungen erkennen und einen granularen Überblick über ihre KI-Risikoposition erhalten, einschließlich Aufschlüsselungen nach Risikokategorie und Benutzeraktivität.
Aufbauend auf dieser strategischen Grundlage schließen wir den Bericht ab, indem wir die Prinzipien dieser Frameworks in eine taktische Roadmap überführen, die sich auf jedes in diesem Bericht definierte Risiko konzentriert. Bei der Durchsicht dieser risikospezifischen Leitlinien werden Sie einige wiederkehrende Themen erkennen:
- Transparenz: Die Bereitstellung eines zentralisierten KI-Gateways oder Proxys ist für alle KI-Interaktionen unerlässlich, einschließlich Schatten-KI, lokaler Infrastruktur und MCP-Datenverkehr.
- Governance: Richtlinien müssen risikoorientiert und granular sein und eine matrixbasierte Genehmigung für Apps und Anwendungsfälle, Governance für die Sicherheit der Lieferkette sowie die Einhaltung regionaler und rechtlicher Compliance-Anforderungen umfassen.
- Schutz: Die Sicherheitsposition muss mehrschichtig sein und Echtzeit-Data-Loss-Prevention (DLP), nicht deterministische semantische Schutzmechanismen, heuristische Ausgabevalidierung und kontinuierliche Verhaltensanalysen verwenden, um Signale nach einer Kompromittierung zu erkennen, beispielsweise Aufklärung und C2.
Nachfolgend haben wir jedem Risiko spezifische Anforderungen an Transparenz, Governance und Schutz zugeordnet und damit einen operativen Plan zur Risikominderung in Ihrer gesamten Umgebung erstellt.
Datenschutzrichtlinienverletzung (vorgelagert)
- Transparenz: Verwenden Sie für alle KI-Interaktionen ein KI-Gateway oder einen Proxy, insbesondere für Schatten-KI.
- Governance: Definieren Sie eine Matrix für Apps und genehmigte Anwendungsfälle, mit Schwerpunkt auf Quellcode, regulierten Daten und geistigem Eigentum.
- Schutz: Konfigurieren Sie Echtzeit-Datenschutzrichtlinien, die an den genehmigten vorgelagerten Anwendungsfällen ausgerichtet sind.
Datenschutzrichtlinienverletzung (nachgelagert)
- Transparenz: Verwenden Sie für alle KI-Interaktionen ein KI-Gateway oder einen Proxy, insbesondere für MCP.
- Governance: Definieren Sie eine Matrix aus Benutzergruppen und erforderlichen Zugriffsstufen für sensible Daten.
- Schutz: Konfigurieren Sie Echtzeit-Datenschutzrichtlinien, die am genehmigten nachgelagerten Datenzugriff ausgerichtet sind.
Inhaltsfilterung
- Transparenz: Verwenden Sie für alle KI-Interaktionen ein KI-Gateway oder einen Proxy, insbesondere für Schatten-KI.
- Governance: Richten Sie die Echtzeit-Textanalyse an den Personalrichtlinien des Unternehmens, rechtlichen Compliance-Kriterien und regionalen Richtlinien zur akzeptablen Nutzung (AUP) aus.
- Schutz: Nutzen Sie KI-Schutzmechanismen mit Kontextbewusstsein und Schlüsselwortfilterung.
Prompt Injection und Jailbreaking
- Transparenz: Verwenden Sie für alle KI-Interaktionen ein KI-Gateway oder einen Proxy, einschließlich lokaler Infrastruktur.
- Governance: Schreiben Sie vor, dass die gesamte KI-Infrastruktur vor der Bereitstellung auf optimale Isolation geprüft wird und Schutzmechanismen enthält.
- Schutz: Implementieren Sie nicht deterministische semantische Schutzmechanismen in Verbindung mit Verhaltensanalysen, um selbst subtilste Versuche von Prompt Injection und Jailbreaks zu erkennen. Ergänzen Sie diese Steuerungen durch Datenschutzrichtlinien und eine Inspektion auf schädlichen Code.
Anfragen nach sensiblen Daten
- Transparenz: Verwenden Sie für alle KI-Interaktionen ein KI-Gateway oder einen Proxy, wobei alle Prompts in Audit-Protokollen erfasst werden.
- Governance: Richten Sie Frameworks für Verantwortlichkeit und Isolation ein, um miteinander verbundene Ressourcen zu begrenzen.
- Schutz: Implementieren Sie nicht deterministische semantische Schutzmechanismen in Verbindung mit Datenschutzrichtlinien und Verhaltensanalysen, um adversariale Versuche zum Zugriff auf sensible Daten zu erkennen.
Piraterie und Urheberrecht
- Transparenz: Verwenden Sie für alle KI-Interaktionen ein KI-Gateway oder einen Proxy, der sämtliche nachgelagerten Inhalte überprüft.
- Governance: Erstellen Sie formelle Compliance-Richtlinien für geistiges Eigentum, die festlegen, welche KI-Modelle und Apps zur Generierung von Code, Textinhalten und anderen sensiblen Inhalten verwendet werden dürfen.
- Schutz: Integrieren Sie für KI-Antworten heuristische Prüfungen zur Ausgabevalidierung, die generierten Quellcode oder Fließtext mit bekannten Open-Source-Signaturen und Markenverzeichnissen abgleichen. Legen Sie Richtlinien fest, um nicht genehmigte Anwendungsfälle einzuschränken, beispielsweise indem bestimmte Modelle für die Generierung von Quellcode gesperrt werden.
Schädlicher Code
- Transparenz: Verwenden Sie für alle KI-Interaktionen ein KI-Gateway oder einen Proxy, der sämtliche nachgelagerten Inhalte überprüft.
- Governance: Schreiben Sie eine Zero-Trust-Validierungsarchitektur für alle internen CI/CD-Pipelines vor, ergänzt durch eine robuste Governance für Lieferkettenrisiken.
- Schutz: Stellen Sie zusätzlich zum Schutz vor Prompt Injection sicher, dass alle Antworten von KI-Apps auf schädlichen Code überprüft werden. Integrieren Sie Bedrohungsscans in Ihre CI/CD-Pipelines und verwenden Sie Verhaltensanalysen, um Signale nach einer Kompromittierung zu erkennen, darunter Aufklärung, C2 und Datenexfiltration.
Über diesen Bericht
Die in diesem Bericht dargestellten Informationen basieren auf aggregierten Nutzungsdaten, die von der Netskope One-Plattform für eine Teilmenge der Netskope-Kunden zwischen Juni 2025 und Juli 2026 erfasst wurden.