

Riepilogo esecutivo e risultati principali
Nel 2026, la strategia aziendale per la sicurezza dell’IA è passata dall’individuazione reattiva della shadow AI alla governance attiva e transazionale degli agenti IA autonomi. La rapida proliferazione dell’IA agentica, unita all’adozione diffusa del Model Context Protocol (MCP) per collegare gli archivi dati interni ai modelli esterni, ha ampliato la superficie di rischio aziendale oltre la semplice esfiltrazione di dati basata sui prompt. Questo report analizza il conseguente panorama della sicurezza dell’IA, descrive i rischi operativi, dalle violazioni dei criteri sui dati downstream all’esecuzione autonoma di codice dannoso, e stabilisce il requisito tecnico per l’ispezione del traffico IA e un’architettura IA zero-trust. Tra i risultati principali di questo report figurano:
- Rischi per la sicurezza dei dati: un’impennata delle violazioni downstream dei criteri Le violazioni downstream dei criteri sui dati, nelle quali un servizio IA restituisce dati sensibili a cui un utente o un agente non è autorizzato ad accedere, sono in forte aumento, spinte da una crescita di 4 volte del traffico MCP mentre le organizzazioni continuano a collegare i sistemi IA ad archivi di dati sensibili.
- Rischi agentici: il passaggio operativo alla programmazione autonoma L’aumento dell’uso degli agenti di programmazione sta determinando una crescita del volume del traffico IA, una maggiore interconnessione MCP e maggiori rischi di esecuzione di codice dannoso: oggi il 75% delle organizzazioni utilizza Claude Code e il 58% utilizza Codex, un incremento drastico rispetto all’adozione trascurabile di un anno fa.
- Rischi avversari: codice, link ed esche dannosi Con l’aumento dell’adozione dell’IA, gli avversari continuano a utilizzare esche legate all’IA per indurre le vittime a scaricare malware o visitare pagine Web dannose. Allo stesso tempo, gli avversari stanno diventando sempre più abili nel fare in modo che le stesse app IA presentino codice dannoso alle vittime, aumentando il rischio che gli agenti di programmazione autonomi eseguano tale codice o lo incorporino in codebase più ampie.
Introduzione
Con la maturazione dell’adozione dell’IA generativa nelle aziende, i responsabili della sicurezza sono passati dalla sfida iniziale dell’individuazione della shadow AI al requisito più complesso di una governance granulare e transazionale. Una governance efficace richiede ora che i team di sicurezza vadano oltre i criteri incentrati principalmente sulla limitazione del flusso di dati verso piattaforme IA di terze parti e adottino invece un framework strutturato di valutazione del rischio che analizzi le interazioni IA secondo quattro dimensioni critiche: volume, direzionalità, gravità e intento. Il panorama delle minacce aziendali è cambiato radicalmente, poiché gli stessi strumenti che favoriscono la produttività (chatbot IA, assistenti IA, agenti IA autonomi, server MCP e così via) ampliano contemporaneamente la superficie di attacco. Sebbene le violazioni upstream dei criteri sui dati, nelle quali utenti e agenti inviano dati sensibili a terze parti in violazione dei criteri organizzativi, rimangano il punto di errore più frequente, sono in aumento i rischi avversari critici, tra cui prompt injection, jailbreaking ed esecuzione downstream di codice dannoso, così come le violazioni downstream dei criteri sui dati derivanti dalla crescente interconnessione dei sistemi IA. Questo report fornisce una panoramica granulare del panorama dei rischi aziendali legati all’IA e delle basi tecniche per implementare la visibilità, la governance e la protezione necessarie per proteggere adeguatamente le implementazioni aziendali dell’IA.
Categorizzazione dei rischi legati all’IA
La visibilità, la governance e la protezione dell’IA iniziano dalla comprensione dell’attuale panorama dei rischi. Il grafico seguente classifica i rischi più diffusi in base alla frequenza delle violazioni osservate nelle organizzazioni. In cima all’elenco si trovano le violazioni upstream dei criteri sui dati, che un tempo rappresentavano quasi il 100% degli avvisi, ma che sono scese sotto il 90% con l’aumento del volume di altri tipi di violazioni. All’estremità opposta si trovano le violazioni relative al codice dannoso, nelle quali un sistema IA restituisce codice dannoso, che sono le meno numerose ma anche le più gravi.
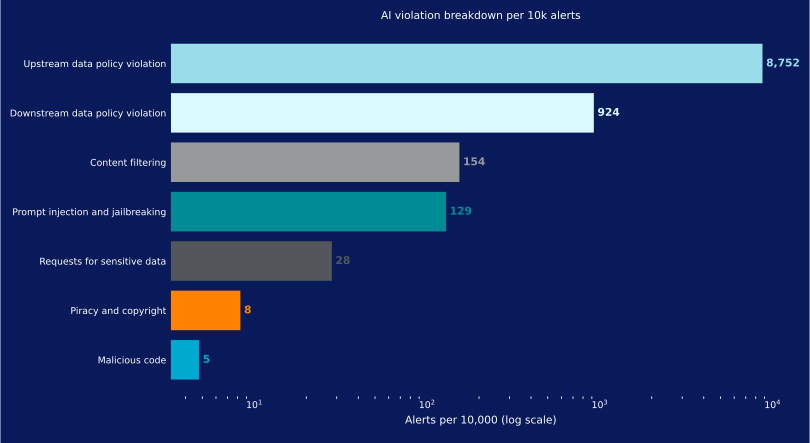
Nell’elenco seguente analizziamo ciascuno di questi rischi in modo più dettagliato, includendo direzione, intento e gravità.
Violazione upstream dei criteri sui dati
Direzione: Upstream
Profilo di intento: Insider/produttività/negligenza
Gravità: Cumulativa
Che cos’è una violazione upstream dei criteri sui dati?
Il rischio IA più comune consiste nel tentativo di un utente o di un agente di inviare dati a un sistema IA in violazione dei criteri dell’organizzazione sull’uso dei dati, incluso l’invio di informazioni riservate o codice sorgente a servizi non approvati. Le organizzazioni utilizzano generalmente tali criteri per indirizzare gli utenti dalla shadow AI verso servizi IA approvati e per indirizzare i casi d’uso verso i servizi appropriati. Ad esempio, alcuni servizi IA potrebbero essere autorizzati esclusivamente per attività di programmazione e sviluppo, mentre altri potrebbero essere autorizzati soltanto a elaborare dati sensibili contenuti in documenti e fogli di calcolo. Le violazioni dei criteri sui dati hanno origine principalmente da insider fidati che cercano di aumentare la propria produttività, ma lo fanno con negligenza, senza conoscere i criteri organizzativi. In questo caso, la gravità del rischio è cumulativa, poiché un’esposizione costante di dati sensibili a terze parti può determinare responsabilità normative o relative alla conformità.
Violazione downstream dei criteri sui dati
Direzione: Downstream
Profilo di intento: Insider/produttività/negligenza
Gravità: Bassa/moderata
Che cos’è una violazione downstream dei criteri sui dati?
Le violazioni downstream dei criteri sui dati si verificano quando un servizio IA restituisce dati ai quali i criteri organizzativi vietano all’utente o all’agente di accedere. Tali violazioni si verificano quando un’organizzazione utilizza MCP, la retrieval-augmented generation (RAG) o modelli personalizzati addestrati su dati proprietari. In questi casi, un’app IA potrebbe restituire dati sensibili provenienti da un sistema collegato ai quali l’utente o l’agente non è autorizzato ad accedere. Un altro esempio, meno comune, di violazione downstream dei criteri sui dati si verifica quando un’organizzazione autorizza un’app, ma ne limita l’utilizzo a uno specifico caso d’uso. Ad esempio, agli utenti e agli agenti potrebbe essere consentito utilizzare l’app come chatbot generico, ma non per generare codice sorgente. Qualsiasi codice sorgente restituito dall’app verrebbe classificato come violazione downstream. Come per le violazioni upstream, il principale profilo di intento delle violazioni downstream è quello di un insider fidato motivato dall’aumento della produttività, mentre la gravità del rischio dipende dal tipo di dati e dall’ampiezza dell’accesso.
Filtraggio dei contenuti
Direzione: Bidirezionale
Profilo di intento: Insider/comportamento
Gravità: Bassa
Che cos’è il filtraggio dei contenuti nel contesto del rischio IA? Le violazioni relative al filtraggio dei contenuti sono bidirezionali e si verificano quando un utente o un agente invia un prompt a un sistema IA, o riceve da esso una risposta, contenente materiale considerato inappropriato dai criteri organizzativi. Questi tipi di violazioni sono simili alle violazioni del filtraggio URL di un secure web gateway (SWG): allo stesso modo in cui le organizzazioni bloccano contenuti sessuali o violenti sul Web, generalmente impediscono anche che tali contenuti vengano restituiti dalle app IA. Le violazioni relative al filtraggio dei contenuti hanno una gravità bassa perché rappresentano una minaccia minima per la rete o per gli asset di dati dell’organizzazione. Si tratta invece principalmente di questioni relative alle risorse umane, alla conformità legale o all’allineamento culturale.
Prompt injection e jailbreaking
Direzione: Bidirezionale
Profilo di intento: Avversario/elusione\
Gravità: Critica
Che cos’è la prompt injection? Che cos’è il jailbreaking? Le violazioni relative a prompt injection e jailbreaking si verificano quando un utente o un agente tenta di aggirare i guardrail, sovvertire le istruzioni di sistema sottostanti o costringere in altro modo un sistema IA a eseguire un’azione soggetta a restrizioni. Tali violazioni derivano da azioni deliberatamente avversarie o elusive da parte di un insider o di un avversario esterno. In molti casi si tratta di attacchi indiretti di prompt injection, nei quali un avversario incorpora istruzioni dannose in fonti di dati esterne a cui accede un sistema IA. La gravità è critica perché lo sfruttamento riuscito sovverte il piano di controllo del modello, attivando potenzialmente percorsi di esecuzione a cascata nei servizi backend collegati.
Richieste di dati sensibili
Direzione: Upstream
Profilo di intento: Avversario/ricognizione/raccolta
Gravità: Alta
Che cosa sono le richieste di dati sensibili nel contesto del rischio IA? Le richieste di dati sensibili sono violazioni upstream che si verificano quando un utente o un agente mostra segni di un tentativo deliberato di aggirare i controlli per accedervi. La gravità di tale violazione è generalmente superiore a quella di una violazione downstream dei criteri sui dati, a causa del diverso profilo di intento. Una violazione downstream dei criteri sui dati potrebbe verificarsi senza una richiesta deliberata, semplicemente perché il sistema ha accesso a dati ai quali l’utente non è autorizzato ad accedere. Al contrario, le richieste di dati sensibili indicano che il richiedente intende accedere a tali dati. Le richieste di dati sensibili, combinate con violazioni downstream dei dati, indicano un rischio critico, poiché suggeriscono che il richiedente stia riuscendo nel proprio intento.
Pirateria e copyright
Direzione: Downstream
Profilo di intento: Conformità/accidentale
Gravità: Bassa
Quali sono i rischi di copyright associati all’IA? Una violazione relativa alla pirateria e al copyright è una violazione downstream che si verifica quando un’applicazione IA restituisce materiale protetto, coperto da copyright o da marchio senza una valida licenza di terze parti o attribuzione dell’autorizzazione. Se utilizzato impropriamente, tale materiale comporta un rischio legale e finanziario per l’organizzazione. Tuttavia, rappresenta una minaccia minima per la rete o per gli asset di dati dell’organizzazione ed è pertanto considerato a basso rischio.
Codice dannoso
Direzione: Downstream
Profilo di intento: Avversario/weaponization
Gravità: Critica
Che cos’è il codice dannoso nel contesto dell’IA? Una violazione relativa al codice dannoso si verifica quando un’applicazione IA restituisce codice dannoso nella propria risposta. Il codice dannoso potrebbe consistere in comandi shell che l’utente o l’agente potrebbe eseguire direttamente oppure in uno snippet di codice dannoso incorporato in una codebase più ampia. Gli agenti di programmazione autonomi, che stanno rapidamente guadagnando popolarità, amplificano questo rischio perché generano codice molto più velocemente degli esseri umani ed eseguono autonomamente codice e comandi generati dall’IA. Un’app IA potrebbe restituire codice dannoso in seguito a una prompt injection indiretta, a strumenti o modelli IA trojanizzati oppure persino in modo organico. Il codice dannoso organico potrebbe essere restituito in seguito all’addestramento su dati vulnerabili, a un disallineamento emergente o a un’allucinazione. La gravità è critica perché l’esecuzione riuscita di codice dannoso potrebbe determinare una compromissione diffusa dei sistemi. Le violazioni relative al codice dannoso, insieme alle violazioni di prompt injection e jailbreaking, rivelano l’intento e indicano un possibile successo.
Adozione dell’IA: crescita continua
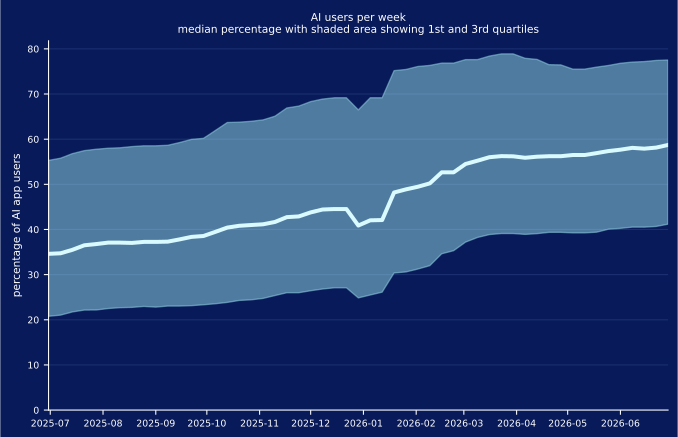
Nell’ultimo anno, la percentuale di utenti aziendali che utilizzano attivamente app IA ogni settimana è aumentata dal 34% al 59% per l’organizzazione mediana, mentre nel quartile superiore delle organizzazioni almeno il 77% della base utenti interagisce ogni settimana con app IA. Nel frattempo, l’1% delle organizzazioni con il maggior numero di utenti IA, non raffigurato, ha già raggiunto un plateau vicino al 100%. Il calo nel grafico alla fine del 2025 e all’inizio del 2026 è un artefatto che compare in tutto il report e deriva da una minore attività complessiva durante il periodo delle festività. Il tasso di adozione dell’IA ha registrato una lieve accelerazione alla fine del 2025 e tale crescita accelerata è proseguita all’inizio del 2026, ma da allora ha rallentato. Prevediamo che questa crescita raggiungerà un plateau nella seconda metà del 2026, man mano che le organizzazioni adotteranno un approccio più strategico ai propri investimenti nell’IA.
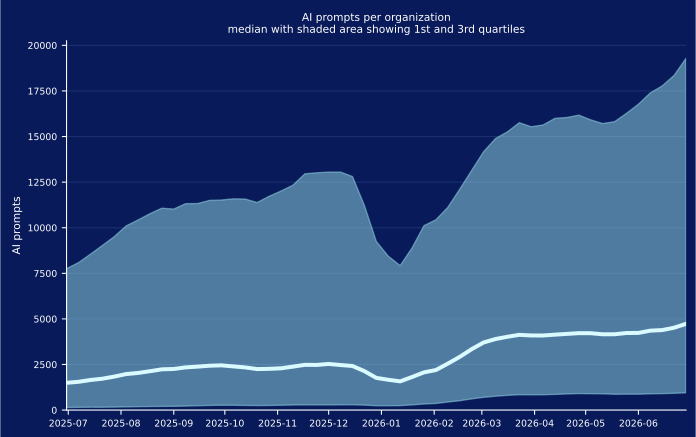
Allo stesso tempo, il volume di utilizzo dell’IA è triplicato, passando in media da 1.498 a 4.731 prompt alla settimana. Il 25% superiore delle organizzazioni ha registrato un volume settimanale significativamente più elevato, pari ad almeno 19.292 prompt, mentre l’1% superiore, non raffigurato, ha registrato centinaia di migliaia di prompt alla settimana. Questo incremento di volume è determinato principalmente dalla crescente adozione dell’IA agentica, che analizziamo più dettagliatamente nella sezione successiva. Prevediamo inoltre che il numero di prompt per organizzazione raggiungerà un plateau nella seconda metà del 2026, quando l’adozione dell’IA agentica arriverà alla saturazione.
Shadow AI: un plateau
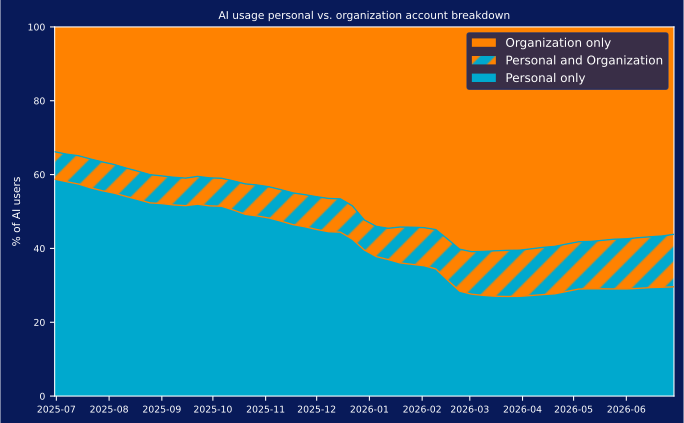
Dall’inizio del boom dell’IA, abbiamo osservato un graduale allontanamento dalle app di shadow AI personali e non gestite a favore di app gestite dalle organizzazioni. Nel 2023, quasi tutto il traffico IA osservato nelle aziende era riconducibile alla shadow AI: singoli utenti sperimentavano con i propri abbonamenti a ChatGPT nel tentativo di aumentare la produttività personale. Nel tempo, le organizzazioni hanno iniziato a distribuire app approvate e gestite e, di conseguenza, la percentuale di utenti che accedevano ad app IA personali è diminuita. Questa tendenza si è interrotta intorno a marzo 2026, ha raggiunto un plateau e ha poi registrato una lieve inversione. Attualmente, il 56% degli utenti IA utilizza esclusivamente applicazioni IA gestite dall’organizzazione, il 14% utilizza sia app gestite dall’organizzazione sia app personali e il 30% utilizza esclusivamente app personali. Questa inversione di tendenza indica che la shadow AI è destinata a rimanere e che, anziché continuare a trasferire ogni utente e caso d’uso IA su piattaforme gestite, le organizzazioni hanno scelto di applicare guardrail all’uso di app personali e non approvate. Allo stesso tempo, le priorità per l’individuazione della shadow AI si sono estese dall’acquisizione di visibilità e dall’implementazione di controlli per l’uso delle app IA personali fino a includere agenti IA, server MCP e infrastruttura IA locale, tutti ambiti nei quali stiamo attualmente osservando una rapida crescita.
IA agentica: un boom della programmazione
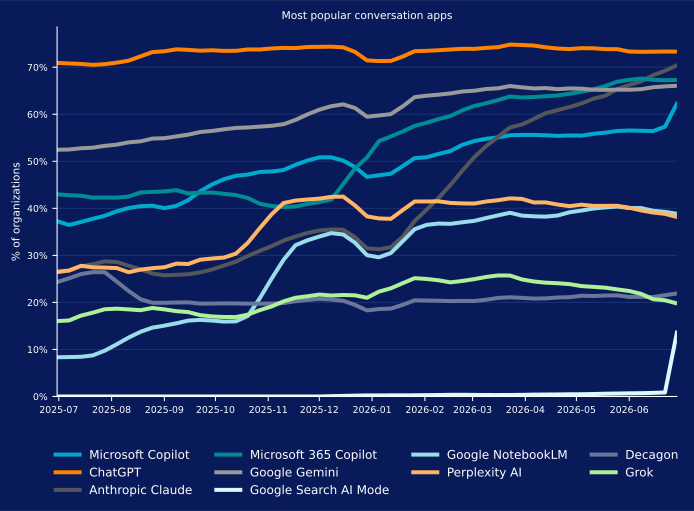
Nell’ultimo anno, l’adozione di app IA chatbot conversazionali ha raggiunto la saturazione, con oltre il 95% delle organizzazioni di tutto il mondo che utilizza un chatbot almeno una volta alla settimana. ChatGPT, da tempo leader globale, rimane al primo posto, ma deve affrontare la concorrenza di Anthropic Claude, Microsoft 365 Copilot e Google Gemini. All’inizio dell’anno, Google Gemini era al secondo posto e sembrava pronto a superare ChatGPT, ma la sua adozione ha raggiunto un plateau. Microsoft 365 Copilot ha superato Google Gemini a maggio, ma ha analogamente raggiunto un plateau. Successivamente, a giugno, Anthropic Claude li ha superati entrambi e continua a crescere in popolarità. La sua popolarità è strettamente legata all’adozione di Claude Code, l’agente di programmazione di Anthropic, che analizziamo più avanti in questa sezione. Se manterrà la traiettoria attuale, Claude è destinato a superare ChatGPT nella seconda metà del 2026.
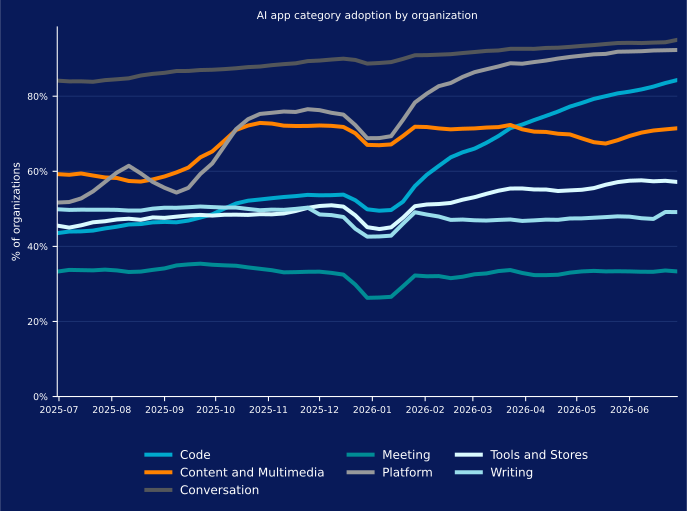
Altre categorie di app IA presentano tassi di adozione complessivi inferiori, rimasti relativamente costanti dall’inizio dell’anno, con due eccezioni degne di nota:
- Le app IA per il codice forniscono strumenti di supporto allo sviluppo software, tra cui scrittura, test, debugging e ottimizzazione del codice. Le app agentiche per lo sviluppo del codice hanno portato la diffusione delle app di programmazione dal 42% all’84%. Inoltre, sebbene l’adozione abbia rallentato rispetto al ritmo rapido osservato all’inizio dell’anno, è destinata a continuare ad aumentare nella seconda metà dell’anno.
- Le piattaforme IA semplificano il processo di sviluppo dell’IA ospitando componenti chiave, come i modelli IA, e consentendo agli sviluppatori di concentrarsi sulla logica principale delle applicazioni senza dover gestire l’infrastruttura. Nell’ultimo anno, l’adozione delle piattaforme IA è aumentata rapidamente dal 51% al 92% delle organizzazioni, ma recentemente ha raggiunto un plateau e si prevede che rimarrà a questo livello per tutta la seconda metà dell’anno.
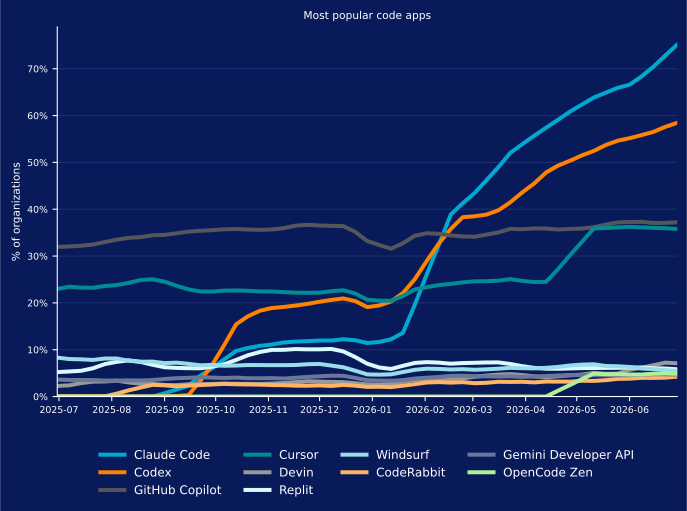
Nel settore delle app IA per il codice, GitHub Copilot e Cursor erano gli operatori dominanti un anno fa. Entrambe sono editor di codice basati sull’IA che utilizzano un IDE tradizionale e vi aggiungono funzionalità IA per assistere il processo di sviluppo software. Sebbene la popolarità di questo approccio sembri aver raggiunto un plateau, le app di programmazione agentica Claude Code e Codex stanno aumentando rapidamente in popolarità. Claude Code è ora la piattaforma di sviluppo del codice più diffusa, utilizzata dal 75% delle organizzazioni, mentre Codex si trova al secondo posto con il 58%. Un anno fa, entrambe queste app avevano un’adozione inferiore all’1%. La continua crescita della popolarità di queste due app sottolinea il passaggio allo sviluppo software agentico in corso nei diversi settori a livello mondiale, che incrementa alcuni dei rischi evidenziati in questo report, in particolare quelli associati a prompt injection e jailbreak, codice dannoso e gestione impropria dei dati sensibili.
Piattaforme IA e sovranità dei dati
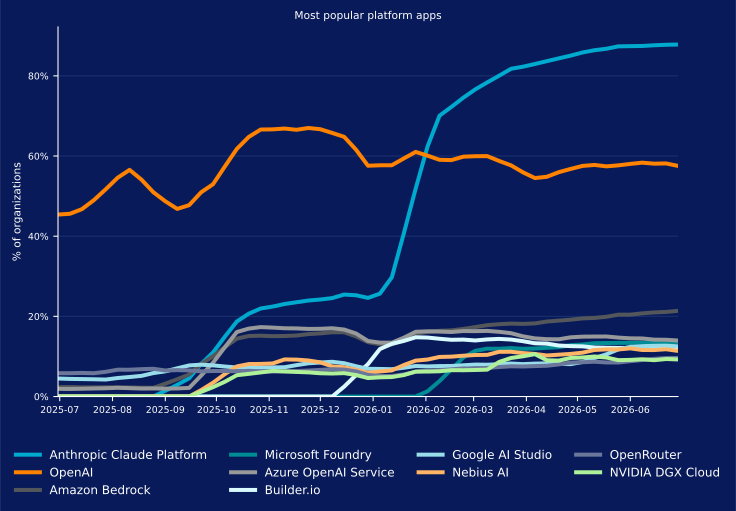
Anche le piattaforme IA stanno registrando una crescente popolarità, guidate dalla Claude Platform di Anthropic. Come evidenziato nel corso di questo report, il chatbot Claude e Claude Code di Anthropic sono cresciuti rapidamente in popolarità dall’inizio dell’anno. La Claude Platform, che consente agli utenti di sviluppare app e agenti personalizzati utilizzando i suoi modelli, ha registrato una crescita analoga e ha superato la piattaforma di OpenAI, un tempo dominante in quest’area.
Allo stesso tempo, numerose altre piattaforme hanno registrato una crescita significativa nel corso dell’anno. Ad esempio, al terzo posto con un notevole distacco, ma in costante crescita di popolarità, si trova Amazon Bedrock. Tra i motivi per cui Bedrock continua a guadagnare popolarità figurano l’ampia varietà di modelli e il suo approccio alla sovranità dei dati, che garantisce che i dati organizzativi siano isolati, crittografati, elaborati esclusivamente nelle regioni scelte e mai condivisi con terze parti o utilizzati per addestrare modelli di base. Detto questo, alcuni modelli prevedono condizioni specifiche, pertanto le organizzazioni dovrebbero esaminare l’uso delle piattaforme, inclusa Amazon Bedrock, modello per modello. Prevediamo comunque che continuerà il passaggio verso piattaforme come Bedrock, man mano che le organizzazioni daranno priorità alla sovranità dei dati.
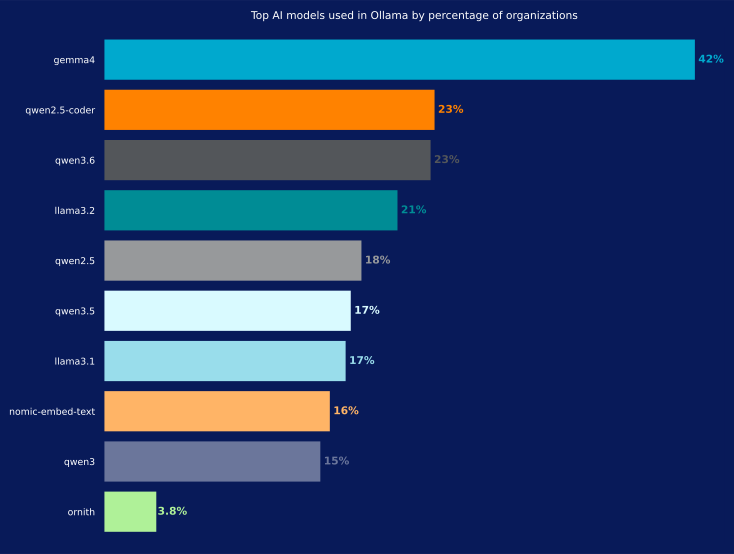
L’esecuzione locale dei modelli sta diventando più diffusa, poiché le organizzazioni attribuiscono sempre maggiore priorità alla sovranità dei dati e cercano di ridurre i costi del cloud. Il 41% delle organizzazioni, più di quelle che utilizzano Bedrock ma meno di quelle che utilizzano le piattaforme OpenAI e Claude, utilizza Ollama. Questo popolare framework open source consente alle organizzazioni di scaricare ed eseguire i modelli localmente. Di seguito è riportata una ripartizione della popolarità dei modelli, dalla quale emerge che Gemma4 di Google è di gran lunga il più diffuso, seguito da diverse versioni di Qwen di Alibaba e Llama di Meta. Prevediamo un significativo rimescolamento di questa classifica nella seconda metà dell’anno, poiché i modelli GLM di Z.ai si stanno attualmente distinguendo nei benchmark e stanno guadagnando popolarità.
MCP: interconnessione in rapido aumento
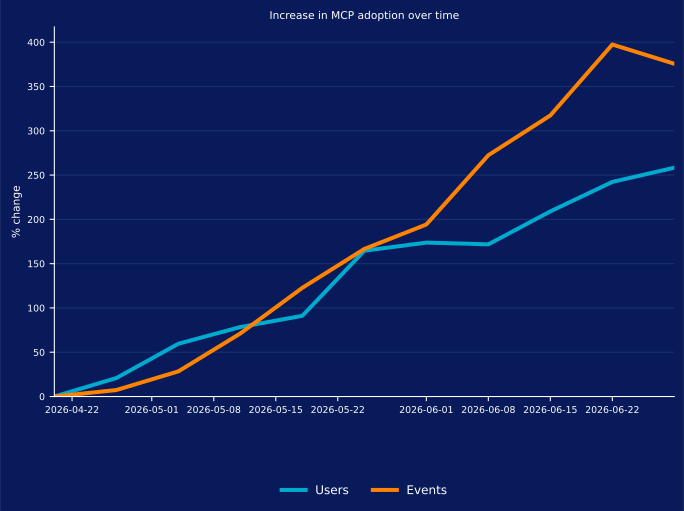
MCP, lo standard open source per collegare i modelli IA a fonti di dati e strumenti esterni, ha registrato un’impennata nell’utilizzo, con un aumento degli utenti del 250% e delle transazioni del 375% soltanto nelle ultime 10 settimane. Questa crescita è significativa perché sta determinando un cambiamento sostanziale nel volume e nella direzione delle violazioni dei criteri sui dati, che analizziamo nella sezione seguente. Inoltre, queste statistiche rappresentano esclusivamente l’utilizzo remoto di MCP, nel quale l’agente si collega a un server MCP ospitato su Internet anziché sul computer locale o all’interno della rete dell’organizzazione. Tra i principali client utilizzati per collegarsi a questi server MCP figurano gli agenti di programmazione IA, Claude Code e Codex, menzionati in precedenza nel report.
Violazioni dei criteri sui dati: volume in crescita
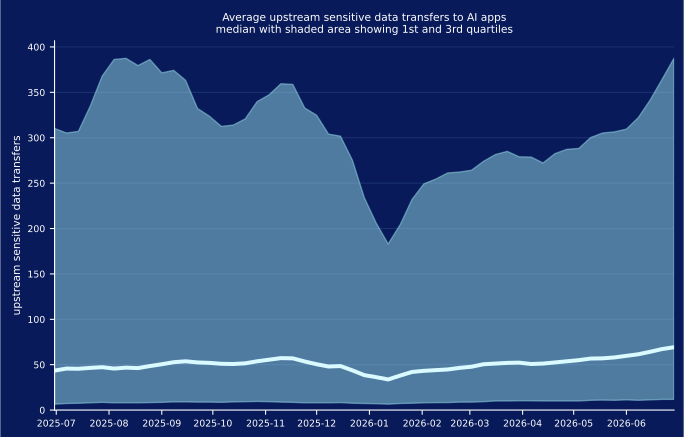
Nell’ultimo anno, il numero di violazioni upstream dei criteri sui dati è aumentato moderatamente: l’organizzazione media ne registra 69 alla settimana, rispetto alle 44 settimanali di un anno fa. Allo stesso tempo, il 25% superiore delle organizzazioni ha registrato fluttuazioni significative nel corso dell’anno, ma continua a osservare circa 300-400 violazioni alla settimana, in modo analogo a quanto registrato nello stesso periodo dell’anno scorso.
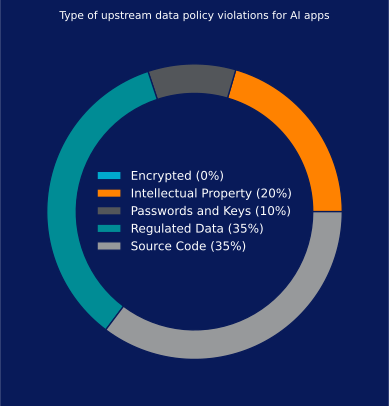
Una ripartizione dei tipi di violazioni mostra che proprietà intellettuale, dati regolamentati e codice sorgente rappresentano la grande maggioranza delle violazioni dei criteri sui dati, mentre una percentuale minore riguarda password e chiavi, generalmente incorporate nel codice sorgente o nei file di configurazione inviati alle app IA.
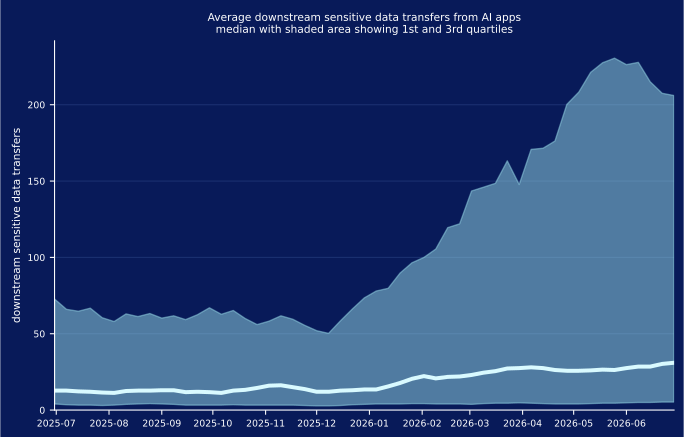
La tendenza delle violazioni downstream dei criteri sui dati nell’ultimo anno è notevolmente diversa da quella delle violazioni upstream. Le violazioni downstream si verificano con una frequenza inferiore rispetto alle violazioni upstream dei criteri sui dati, ma nell’ultimo anno sono più che raddoppiate, passando da 12 a 31 alla settimana. Nel 25% superiore delle organizzazioni, questa frequenza è aumentata da 72 a 206 alla settimana. L’incremento coincide con la crescente adozione dell’IA agentica e di MCP e con il progressivo collegamento delle app IA a fonti di dati e strumenti che espongono dati sensibili. Con il continuo aumento dell’adozione di MCP, prevediamo che la percentuale di violazioni downstream dei dati crescerà complessivamente durante la seconda metà del 2026.
Minacce adiacenti all’IA
Sebbene gran parte di questo report sia incentrata sulle nuove minacce native dell’IA, che con maggiore probabilità richiederanno nuovi controlli, è comunque importante sottolineare che la crescente adozione dell’IA comporta rischi derivanti dalle tradizionali minacce adiacenti all’IA. In questa sezione evidenziamo due minacce di questo tipo: esche IA e link IA.
Esche IA dannose
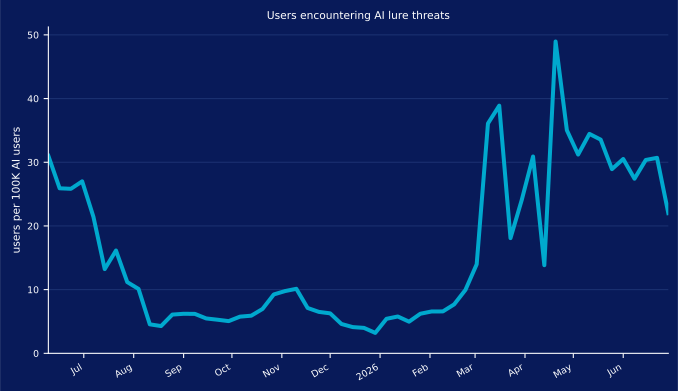
Un’esca IA dannosa tenta di indurre le vittime a scaricare malware o visitare un sito Web dannoso utilizzando un branding contraffatto. Nell’ultimo anno abbiamo osservato una pausa di sei mesi nel numero di esche IA, prima di un’impennata a marzo e del mantenimento di un livello analogo fino a luglio. Tra le recenti campagne che hanno sfruttato esche IA figurano programmi di installazione contraffatti di app IA e strumenti per sviluppatori trojanizzati. Data la continua popolarità dell’IA e le pressioni organizzative per sfruttarla al fine di aumentare la produttività, prevediamo che gli avversari continueranno a creare sofisticate esche IA, come questi programmi di installazione contraffatti, e a individuare nuovi modi per compromettere le pipeline di sviluppo software IA, inclusi ulteriori attacchi in stile Shai-Hulud e la creazione di pacchetti dannosi che occupano abusivamente i nomi che i modelli IA tendono ad allucinare.
Link IA dannosi
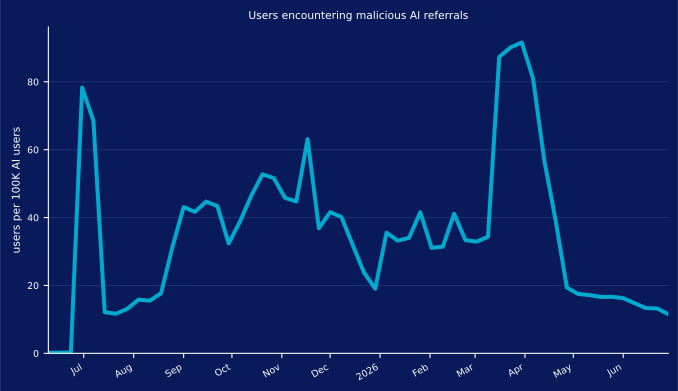
Un link IA dannoso è un link dannoso restituito da un’app IA sul quale un utente fa clic o che un agente visita. È possibile considerarlo simile a un link dannoso sul quale gli utenti fanno clic quando utilizzano un motore di ricerca popolare come Bing o Google. Questi link compaiono nei risultati di ricerca perché l’autore dell’attacco ha utilizzato tecniche SEO per ottenere un posizionamento elevato del proprio sito dannoso, ha pagato per inserire nei risultati di ricerca un annuncio collegato a contenuti dannosi o ha altrimenti compromesso un’infrastruttura legittima. Nel mondo dell’IA, la tecnologia è cambiata, ma le tecniche rimangono. AIEO sta emergendo con la diffusione delle tecniche per fare in modo che i propri contenuti vengano trattati favorevolmente dai modelli IA, mentre gli annunci stanno iniziando a comparire nelle app IA. Il volume di queste minacce è variato significativamente nel corso dell’anno, passando da meno di 10 a più di 90 alla settimana, e prevediamo che il numero medio aumenterà nella seconda metà del 2026, nonostante l’attuale pausa.
Visibilità, governance e protezione
Per gestire il rischio IA, le organizzazioni dovrebbero allineare le proprie strategie di sicurezza a framework ampiamente adottati come MITRE ATLAS e OWASP Top 10 for LLMs. Questi framework forniscono un contesto critico: MITRE ATLAS consente ai CISO di contestualizzare gli attacchi specifici rilevati e bloccati, mentre OWASP LLM Top 10 chiarisce i rischi a livello applicativo. Integrando questi framework con il monitoraggio in tempo reale, i team di sicurezza possono verificare efficacemente l’applicazione dei criteri, rilevare le minacce emergenti e ottenere una visione granulare della propria postura di rischio IA, incluse le ripartizioni per categoria di rischio e attività degli utenti. Partendo da questa base strategica, completiamo il report traducendo i principi di questi framework in una roadmap tattica incentrata su ciascun rischio definito in questo documento. Analizzando queste indicazioni specifiche per ciascun rischio, emergono alcuni temi ricorrenti:
- Visibilità: l’implementazione di un gateway o proxy IA centralizzato è essenziale per tutte le interazioni IA, incluse shadow AI, infrastruttura locale e traffico MCP.
- Governance: i criteri devono essere allineati al rischio e granulari, includendo un’approvazione a matrice per app e casi d’uso, la governance della sicurezza della supply chain e il rispetto dei requisiti normativi e legali regionali.
- Protezione: la postura di sicurezza deve essere stratificata, utilizzando la prevenzione della perdita di dati (DLP) in tempo reale, guardrail semantici non deterministici, convalida euristica dell’output e analisi comportamentale continua per rilevare segnali successivi alla compromissione, ad esempio ricognizione e C2.
Di seguito abbiamo associato specifici requisiti di visibilità, governance e protezione a ciascun rischio, fornendo un modello operativo per mitigarli nell’intero ambiente.
Violazione dei criteri sui dati (upstream)
- Visibilità: utilizzare un gateway o proxy IA per tutte le interazioni IA, in particolare per la shadow AI.
- Governance: definire una matrice per le app e i casi d’uso approvati, con particolare attenzione a codice sorgente, dati regolamentati e proprietà intellettuale.
- Protezione: configurare criteri di protezione dei dati in tempo reale allineati ai casi d’uso upstream approvati.
Violazione dei criteri sui dati (downstream)
- Visibilità: utilizzare un gateway o proxy IA per tutte le interazioni IA, in particolare per MCP.
- Governance: definire una matrice dei gruppi di utenti e dei livelli di accesso necessari ai dati sensibili.
- Protezione: configurare criteri di protezione dei dati in tempo reale allineati all’accesso downstream ai dati approvato.
Filtraggio dei contenuti
- Visibilità: utilizzare un gateway o proxy IA per tutte le interazioni IA, in particolare per la shadow AI.
- Governance: allineare l’analisi del testo in tempo reale ai criteri aziendali delle risorse umane, ai criteri di conformità legale e ai criteri regionali di utilizzo accettabile (AUP).
- Protezione: sfruttare guardrail IA dotati di consapevolezza contestuale e filtraggio per parole chiave.
Prompt injection e jailbreaking
- Visibilità: utilizzare un gateway o proxy IA per tutte le interazioni IA, inclusa l’infrastruttura locale.
- Governance: imporre che tutta l’infrastruttura IA venga esaminata prima dell’implementazione per garantire un isolamento ottimale e includa guardrail.
- Protezione: implementare guardrail semantici non deterministici, abbinati all’analisi comportamentale, per rilevare anche i tentativi più sottili di prompt injection e jailbreak, e stratificare questi controlli con criteri di protezione dei dati e ispezione del codice dannoso.
Richieste di dati sensibili
- Visibilità: utilizzare un gateway o proxy IA per tutte le interazioni IA, con registrazione di audit di tutti i prompt.
- Governance: stabilire framework di proprietà e isolamento per limitare le risorse interconnesse.
- Protezione: implementare guardrail semantici non deterministici, abbinati a criteri di protezione dei dati e analisi comportamentale, per rilevare i tentativi avversari di accedere a dati sensibili.
Pirateria e copyright
- Visibilità: utilizzare un gateway o proxy IA per tutte le interazioni IA, che ispezioni tutti i contenuti downstream.
- Governance: redigere linee guida formali sulla conformità della proprietà intellettuale che specifichino quali modelli e app IA possano essere utilizzati per generare codice, risorse testuali e altri contenuti sensibili.
- Protezione: integrare controlli euristici di convalida dell’output che confrontino il codice sorgente o il testo generato con firme open source note e indici dei marchi per le risposte IA. Impostare criteri per limitare i casi d’uso non approvati, ad esempio impedendo l’utilizzo di determinati modelli per generare codice sorgente.
Codice dannoso
- Visibilità: utilizzare un gateway o proxy IA per tutte le interazioni IA, che ispezioni tutti i contenuti downstream.
- Governance: imporre un’architettura di convalida zero-trust in tutte le pipeline CI/CD interne, con una solida governance del rischio della supply chain.
- Protezione: oltre a proteggere dalla prompt injection, assicurarsi che tutte le risposte delle app IA vengano ispezionate alla ricerca di codice dannoso, integrare la scansione delle minacce nelle pipeline CI/CD e utilizzare l’analisi comportamentale per rilevare segnali successivi alla compromissione, come ricognizione, C2 ed esfiltrazione di dati.
Informazioni su questo report
Le informazioni presentate in questo report si basano su dati di utilizzo aggregati raccolti dalla piattaforma Netskope One per un sottoinsieme di clienti Netskope da giugno 2025 a luglio 2026.