

Résumé analytique et principales conclusions
En 2026, la stratégie de sécurité de l’IA en entreprise est passée de la découverte réactive de l’IA fantôme à la gouvernance active et transactionnelle des agents d’IA autonomes. La prolifération rapide de l’IA agentique, associée à l’adoption généralisée du protocole de contexte modèle (MCP) pour relier les référentiels de données internes aux modèles externes, a étendu la surface de risque des entreprises au-delà de la simple exfiltration de données fondée sur des invites. Ce rapport analyse le paysage de sécurité de l’IA qui en résulte, caractérise les risques opérationnels allant des violations de la politique de données en aval à l’exécution autonome de code malveillant, et établit l’impératif technique d’une inspection du trafic d’IA et d’une architecture d’IA zéro confiance. Parmi les principales conclusions de ce rapport figurent les suivantes :
- Risques liés à la sécurité des données : une forte hausse des violations de la politique de données en aval Les violations de la politique de données en aval, dans lesquelles un service d’IA renvoie des données sensibles auxquelles un utilisateur ou un agent n’est pas autorisé à accéder, augmentent fortement, sous l’effet d’une multiplication par quatre du trafic MCP, alors que les organisations continuent de connecter leurs systèmes d’IA à des référentiels de données sensibles.
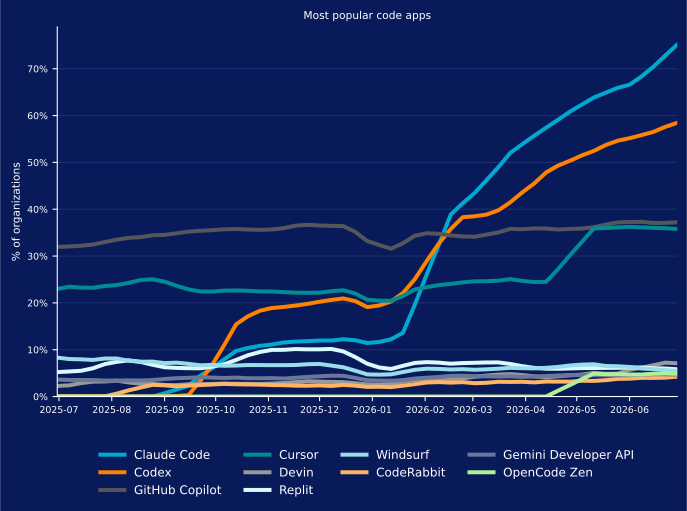
- Risques agentiques : le basculement opérationnel vers le codage autonome L’essor de l’utilisation des agents de codage entraîne une augmentation du volume du trafic d’IA, une interconnexion accrue via MCP et des risques plus élevés d’exécution de code malveillant. Aujourd’hui, 75 % des organisations utilisent Claude Code et 58 % utilisent Codex, soit une hausse spectaculaire par rapport à une adoption négligeable il y a un an.
- Risques adverses : code, liens et leurres malveillants À mesure que l’adoption de l’IA progresse, les adversaires continuent d’utiliser des leurres liés à l’IA pour inciter leurs victimes à télécharger des malware ou à consulter des pages web malveillantes. Parallèlement, ils parviennent de mieux en mieux à amener les applications d’IA elles-mêmes à présenter du code malveillant à leurs victimes, ce qui accroît le risque que des agents de codage autonomes exécutent ce code ou l’intègrent à des bases de code plus vastes.
Introduction
À mesure que l’adoption de l’IA générative gagne en maturité au sein des entreprises, les responsables de la sécurité sont passés du défi initial consistant à découvrir l’IA fantôme à l’exigence plus complexe d’une gouvernance granulaire et transactionnelle. Une gouvernance efficace exige désormais que les équipes de sécurité dépassent les politiques principalement axées sur la limitation des flux de données vers des plateformes d’IA tierces et adoptent plutôt un cadre structuré d’évaluation des risques qui examine les interactions avec l’IA selon quatre dimensions critiques : volume, directionnalité, gravité et intention. Le paysage des menaces pesant sur les entreprises a fondamentalement changé, car les mêmes outils qui améliorent la productivité — chatbots d’IA, assistants d’IA, agents d’IA autonomes, serveurs MCP, etc. — élargissent simultanément la surface d’attaque. Bien que les violations de la politique de données en amont, dans lesquelles des utilisateurs et des agents envoient des données sensibles à des tiers en violation des politiques de l’organisation, restent le point de défaillance le plus fréquent, les risques adverses critiques, notamment l’injection d’invites, le jailbreaking et l’exécution en aval de code malveillant, sont en hausse, tout comme les violations de la politique de données en aval résultant de l’interconnexion croissante des systèmes d’IA. Ce rapport fournit une vue d’ensemble granulaire du paysage des risques liés à l’IA en entreprise et présente les fondements techniques de la mise en œuvre de la visibilité, de la gouvernance et de la protection nécessaires pour sécuriser correctement les déploiements d’IA en entreprise.
Catégorisation des risques liés à l’IA
La visibilité, la gouvernance et la protection de l’IA commencent par une compréhension du paysage actuel des risques. Le graphique ci-dessous classe les risques les plus répandus selon la fréquence des violations observées au sein des organisations. En tête de cette liste figurent les violations de la politique de données en amont, qui représentaient autrefois près de 100 % des alertes, mais sont tombées sous la barre des 90 % à mesure que le volume d’autres types de violations augmentait. À l’autre extrémité du spectre figurent les violations impliquant du code malveillant, dans lesquelles un système d’IA renvoie du code malveillant. Elles sont les moins nombreuses, mais aussi les plus graves.
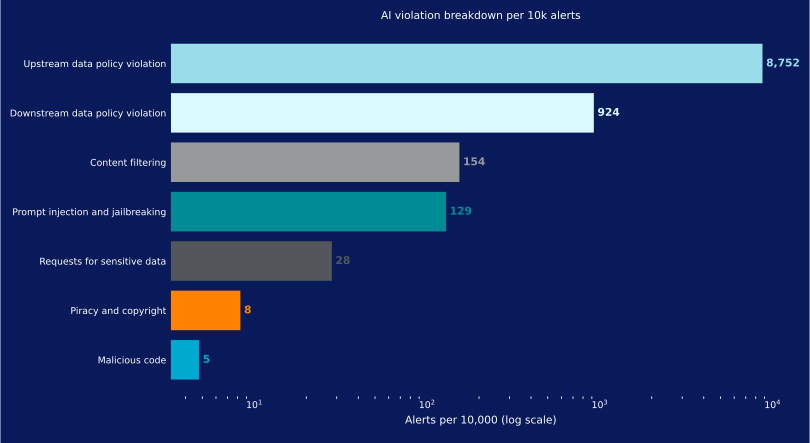
Dans la liste suivante, nous examinons chacun de ces risques plus en détail, notamment sa direction, son intention et sa gravité.
Violation de la politique de données en amont
Direction : En amont
Profil d’intention : Interne/productivité/négligence
Gravité : Cumulative
Qu’est-ce qu’une violation de la politique de données en amont ?
Le risque lié à l’IA le plus courant concerne un utilisateur ou un agent qui tente d’envoyer des données à un système d’IA en violation des politiques d’utilisation des données de l’organisation, notamment en envoyant des informations confidentielles ou du code source à des services non approuvés. Les organisations utilisent généralement ces politiques pour détourner leurs utilisateurs de l’IA fantôme au profit de services d’IA approuvés, et pour orienter les cas d’utilisation vers les services appropriés. Par exemple, certains services d’IA peuvent être autorisés uniquement pour les tâches de codage et de développement, tandis que d’autres sont exclusivement autorisés à traiter des données sensibles contenues dans des documents et des feuilles de calcul. Les violations de la politique de données proviennent principalement de personnes internes de confiance qui cherchent à accroître leur productivité, mais agissent avec négligence, sans connaître la politique de l’organisation. La gravité du risque est ici cumulative, car un flux continu d’exposition de données sensibles à des tiers peut engager la responsabilité de l’organisation en matière de conformité ou de réglementation.
Violation de la politique de données en aval
Direction : En aval
Profil d’intention : Interne/productivité/négligence
Gravité : Faible/modérée
Qu’est-ce qu’une violation de la politique de données en aval ?
Les violations de la politique de données en aval se produisent lorsqu’un service d’IA renvoie des données auxquelles les politiques de l’organisation interdisent à l’utilisateur ou à l’agent d’accéder. De telles violations surviennent lorsqu’une organisation utilise MCP, la génération augmentée par récupération (RAG) ou des modèles personnalisés entraînés sur des données propriétaires. Dans ces cas, une application d’IA peut renvoyer des données sensibles provenant d’un système connecté auxquelles l’utilisateur ou l’agent n’est pas autorisé à accéder. Un autre exemple, moins courant, de violation de la politique de données en aval se produit lorsqu’une organisation autorise une application, mais limite son utilisation à un cas d’utilisation précis. Par exemple, les utilisateurs et les agents peuvent être autorisés à utiliser l’application comme chatbot généraliste, mais pas pour générer du code source. Tout code source renvoyé par l’application serait alors classé comme une violation en aval. Comme pour les violations en amont, le principal profil d’intention associé aux violations en aval est celui d’une personne interne de confiance motivée par un gain de productivité, et la gravité du risque dépend du type de données et de l’étendue de l’accès.
Filtrage du contenu
Direction : Bidirectionnelle
Profil d’intention : Interne/comportement
Gravité : Faible
Qu’est-ce que le filtrage du contenu dans le contexte des risques liés à l’IA ? Les violations liées au filtrage du contenu sont bidirectionnelles et se produisent lorsqu’un utilisateur ou un agent envoie une invite à un système d’IA, ou reçoit de celui-ci une réponse, contenant un contenu jugé inapproprié au regard des politiques de l’organisation. Ces types de violations sont comparables aux violations liées au filtrage des URL par une passerelle web sécurisée (SWG) : de la même manière que les organisations bloquent les contenus sexuels ou violents sur le web, elles empêchent généralement les applications d’IA de renvoyer de tels contenus. Les violations liées au filtrage du contenu sont de faible gravité, car elles représentent une menace minimale pour le réseau ou les actifs de données de l’organisation. Elles relèvent principalement des ressources humaines, de la conformité juridique ou de l’alignement culturel.
Injection d’invites et jailbreaking
Direction : Bidirectionnelle
Profil d’intention : Adverse/contournement\
Gravité : Critique
Qu’est-ce que l’injection d’invites ? Qu’est-ce que le jailbreaking ? Les violations liées à l’injection d’invites et au jailbreaking se produisent lorsqu’un utilisateur ou un agent tente de contourner des garde-fous, de détourner les instructions système sous-jacentes ou de forcer de toute autre manière un système d’IA à effectuer une action restreinte. De telles violations résultent d’actions délibérément adverses ou destinées à contourner les mesures de sécurité, menées par une personne interne ou un adversaire externe. Dans de nombreux cas, il s’agit d’attaques indirectes par injection d’invites, dans lesquelles un adversaire intègre des instructions malveillantes à des sources de données externes auxquelles accède un système d’IA. La gravité est critique, car une exploitation réussie détourne le plan de contrôle du modèle, ce qui peut déclencher des chaînes d’exécution en cascade dans les services backend connectés.
Demandes de données sensibles
Direction : En amont
Profil d’intention : Adverse/reconnaissance/collecte
Gravité : Élevée
Que sont les demandes de données sensibles dans le contexte des risques liés à l’IA ? Les demandes de données sensibles sont des violations en amont qui se produisent lorsqu’un utilisateur ou un agent montre des signes d’une tentative délibérée de contourner les contrôles afin d’y accéder. La gravité d’une telle violation est généralement supérieure à celle d’une violation de la politique de données en aval en raison d’un profil d’intention différent. Une violation de la politique de données en aval peut se produire sans sollicitation délibérée, simplement parce que le système a accès à des données auxquelles l’utilisateur n’est pas autorisé à accéder. À l’inverse, les demandes de données sensibles indiquent que le demandeur entend accéder à ces données. Les demandes de données sensibles, lorsqu’elles sont associées à des violations de données en aval, signalent un risque critique, car elles suggèrent que le demandeur parvient à ses fins.
Piratage et droits d’auteur
Direction : En aval
Profil d’intention : Conformité/accidentel
Gravité : Faible
Quels sont les risques liés aux droits d’auteur associés à l’IA ? Une violation liée au piratage et aux droits d’auteur est une violation en aval qui se produit lorsqu’une application d’IA renvoie des contenus protégés par des droits d’auteur ou des marques sans licence tierce valide ni attribution de l’autorisation. De tels contenus présentent un risque juridique et financier pour l’organisation s’ils sont utilisés de manière inappropriée. Ils constituent toutefois une menace minimale pour le réseau ou les actifs de données de l’organisation et sont donc considérés comme présentant un risque faible.
Code malveillant
Direction : En aval
Profil d’intention : Adverse/armement
Gravité : Critique
Qu’est-ce qu’un code malveillant dans le contexte de l’IA ? Une violation impliquant du code malveillant se produit lorsqu’une application d’IA renvoie du code malveillant dans sa réponse. Le code malveillant peut prendre la forme de commandes shell que l’utilisateur ou l’agent peut exécuter directement, ou d’un extrait de code malveillant intégré à une base de code plus vaste. Les agents de codage autonomes, dont la popularité augmente rapidement, amplifient ce risque, car ils génèrent du code beaucoup plus rapidement que les humains et exécutent de manière autonome du code et des commandes générés par l’IA. Une application d’IA peut renvoyer du code malveillant à la suite d’une injection indirecte d’invites, d’outils ou de modèles d’IA transformés en chevaux de Troie, ou même de manière organique. Du code malveillant organique peut être renvoyé à la suite d’un entraînement sur des données vulnérables, d’un désalignement émergent ou d’une hallucination. La gravité est critique, car l’exécution réussie de code malveillant peut entraîner une compromission généralisée des systèmes. Les violations impliquant du code malveillant, lorsqu’elles sont associées à des violations liées à l’injection d’invites et au jailbreaking, révèlent une intention et indiquent une réussite possible.
Adoption de l’IA : une croissance continue
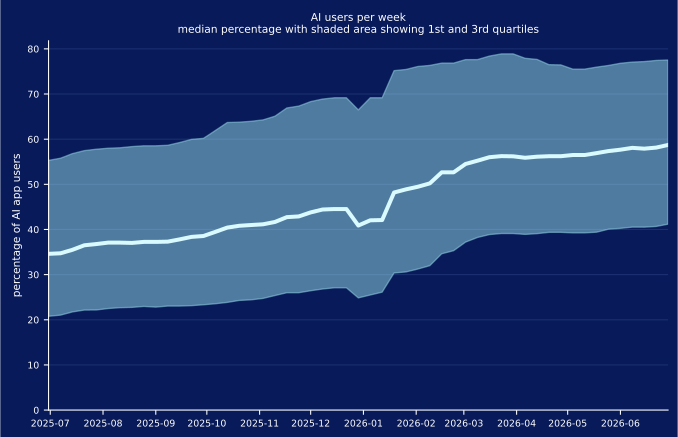
Au cours de l’année écoulée, le pourcentage d’utilisateurs en entreprise utilisant activement des applications d’IA chaque semaine est passé de 34 % à 59 % dans l’organisation médiane, tandis que le quartile supérieur des organisations compte au moins 77 % de ses utilisateurs interagissant avec des applications d’IA chaque semaine. Parallèlement, le 1 % des organisations comptant le plus grand nombre d’utilisateurs de l’IA, non représenté, a déjà atteint un plateau proche de 100 %. Le creux observé sur le graphique à la fin de 2025 et au début de 2026 est un artefact qui apparaît dans l’ensemble de ce rapport et résulte d’une activité globale plus faible pendant la période des fêtes. Le rythme d’adoption de l’IA s’est légèrement accéléré à la fin de 2025, et cette croissance accélérée s’est poursuivie au début de 2026, mais elle a depuis ralenti. Nous prévoyons que cette croissance atteindra un plateau au second semestre 2026, à mesure que les organisations adopteront une approche plus stratégique de leurs investissements dans l’IA.
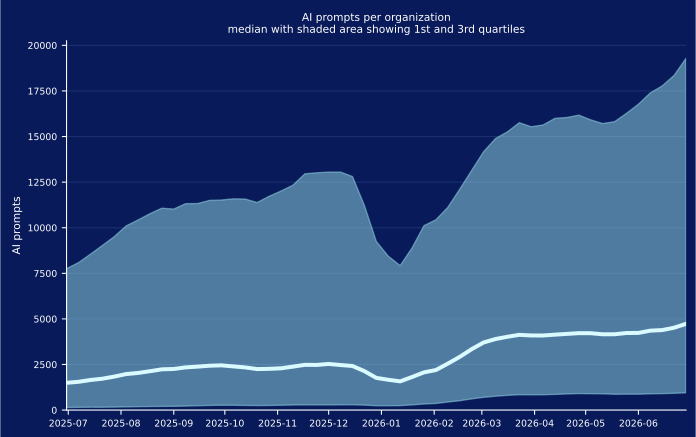
Dans le même temps, le volume d’utilisation de l’IA a triplé, passant en moyenne de 1 498 à 4 731 invites par semaine. Les 25 % d’organisations affichant les niveaux les plus élevés ont enregistré un volume hebdomadaire nettement supérieur d’au moins 19 292 invites, tandis que le 1 % supérieur, non représenté, en a enregistré des centaines de milliers par semaine. Cette augmentation du volume est principalement due à l’adoption croissante de l’IA agentique, que nous examinons plus en détail dans la section suivante. Nous prévoyons également que le nombre d’invites par organisation atteindra un plateau au second semestre 2026, lorsque l’adoption de l’IA agentique arrivera à saturation.
IA fantôme : un plateau
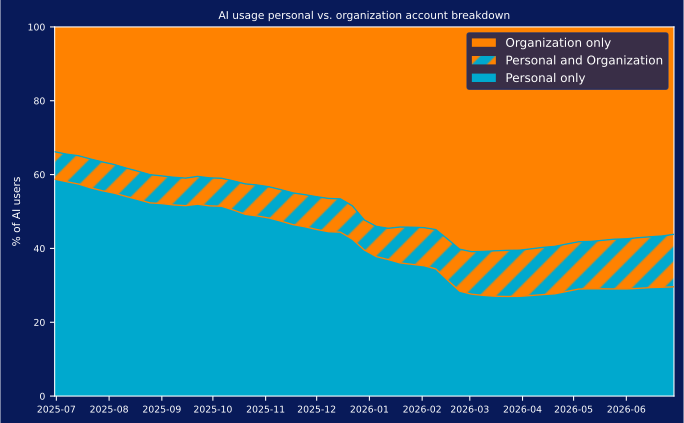
Depuis le début de l’essor de l’IA, nous avons observé un abandon progressif des applications d’IA fantôme personnelles et non gérées au profit d’applications gérées par les organisations. En 2023, la quasi-totalité du trafic d’IA observé en entreprise relevait de l’IA fantôme : des utilisateurs individuels expérimentaient avec leurs abonnements ChatGPT pour tenter d’améliorer leur propre productivité. Au fil du temps, les organisations ont commencé à déployer des applications approuvées et gérées, ce qui a entraîné une diminution du pourcentage d’utilisateurs accédant à des applications d’IA personnelles. Cette tendance s’est interrompue vers mars 2026, a atteint un plateau, puis s’est légèrement inversée. À l’heure actuelle, 56 % des utilisateurs de l’IA utilisent uniquement des applications d’IA gérées par leur organisation, 14 % utilisent à la fois des applications gérées par leur organisation et des applications personnelles, et 30 % utilisent uniquement des applications personnelles. Cette inversion de tendance indique que l’IA fantôme est appelée à perdurer et que, plutôt que de continuer à transférer chaque utilisateur et chaque cas d’utilisation de l’IA vers des plateformes gérées, les organisations ont choisi de mettre en place des garde-fous autour de l’utilisation d’applications personnelles et non approuvées. Dans le même temps, les priorités relatives à la découverte de l’IA fantôme se sont étendues au-delà de l’obtention de la visibilité et de la mise en œuvre de contrôles pour l’utilisation d’applications d’IA personnelles, afin d’inclure les agents d’IA, les serveurs MCP et l’infrastructure d’IA locale, autant de domaines dans lesquels nous observons actuellement une croissance rapide.
IA agentique : un essor du codage
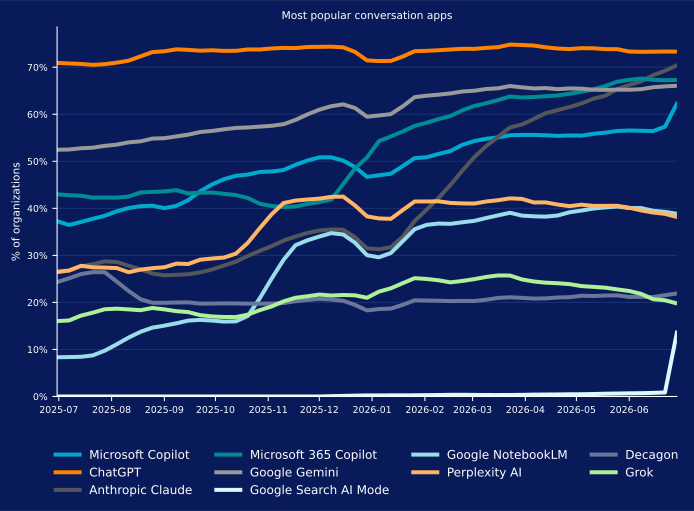
Au cours de l’année écoulée, l’adoption des applications d’IA conversationnelle de type chatbot est arrivée à saturation, plus de 95 % des organisations dans le monde utilisant un chatbot au moins une fois par semaine. ChatGPT, leader mondial de longue date, conserve la première place, mais fait face à la concurrence d’Anthropic Claude, de Microsoft 365 Copilot et de Google Gemini. Au début de l’année, Google Gemini occupait la deuxième place et semblait en mesure de dépasser ChatGPT, mais son adoption a atteint un plateau. Microsoft 365 Copilot a dépassé Google Gemini en mai, mais a également atteint un plateau. Puis, en juin, Anthropic Claude a dépassé les deux et continue de gagner en popularité. Sa popularité est étroitement liée à l’adoption de Claude Code, l’agent de codage d’Anthropic, que nous examinons plus loin dans cette section. Si sa trajectoire actuelle se maintient, Claude devrait dépasser ChatGPT au second semestre 2026.
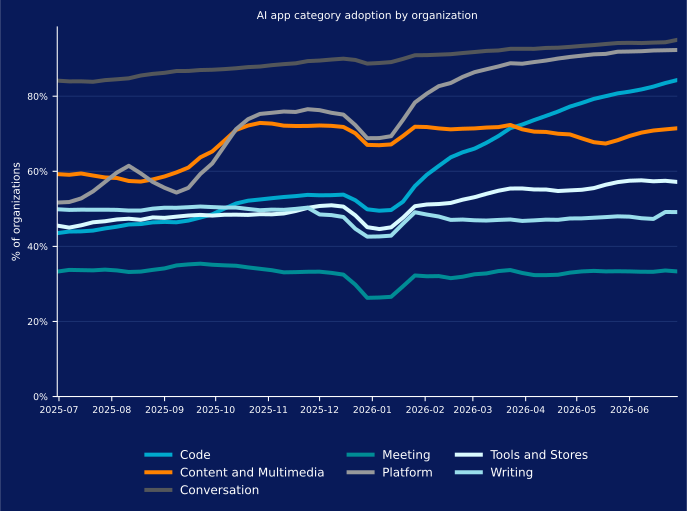
Les autres catégories d’applications d’IA affichent des taux d’adoption globaux plus faibles, restés relativement constants depuis le début de l’année, à deux exceptions notables :
- Les applications de code d’IA fournissent des outils destinés à faciliter le développement logiciel, notamment l’écriture, les tests, le débogage et l’optimisation du code. Les applications de développement de code agentiques ont fait progresser la popularité des applications de code de 42 % à 84 %. En outre, bien que l’adoption ait ralenti par rapport au rythme rapide observé au début de l’année, elle devrait continuer d’augmenter au second semestre.
- Les plateformes d’IA rationalisent le processus de développement de l’IA en hébergeant des composants clés tels que les modèles d’IA, ce qui permet aux développeurs de se concentrer sur la logique principale de l’application sans gérer l’infrastructure. L’adoption des plateformes d’IA a rapidement progressé, passant de 51 % à 92 % des organisations au cours de l’année écoulée, mais elle a récemment atteint un plateau et devrait rester à ce niveau pendant tout le second semestre.
Dans le domaine des applications de code d’IA, GitHub Copilot et Cursor dominaient le marché il y a un an. Ces deux applications sont des éditeurs de code alimentés par l’IA qui utilisent un IDE traditionnel et y ajoutent des fonctionnalités d’IA pour faciliter le processus de développement logiciel. Alors que la popularité de cette approche semble avoir atteint un plateau, les applications de codage agentiques Claude Code et Codex gagnent rapidement en popularité. Claude Code est désormais la plateforme de développement de code la plus populaire, utilisée par 75 % des organisations, tandis que Codex occupe la deuxième place avec 58 %. Il y a un an, le taux d’adoption de ces deux applications était inférieur à 1 %. La popularité toujours croissante de ces deux applications souligne le basculement vers le développement logiciel agentique qui s’opère dans tous les secteurs à l’échelle mondiale, ce qui accroît certains risques mis en évidence dans ce rapport, en particulier ceux associés à l’injection d’invites et au jailbreaking, au code malveillant et à la mauvaise gestion des données sensibles.
Plateformes d’IA et souveraineté des données
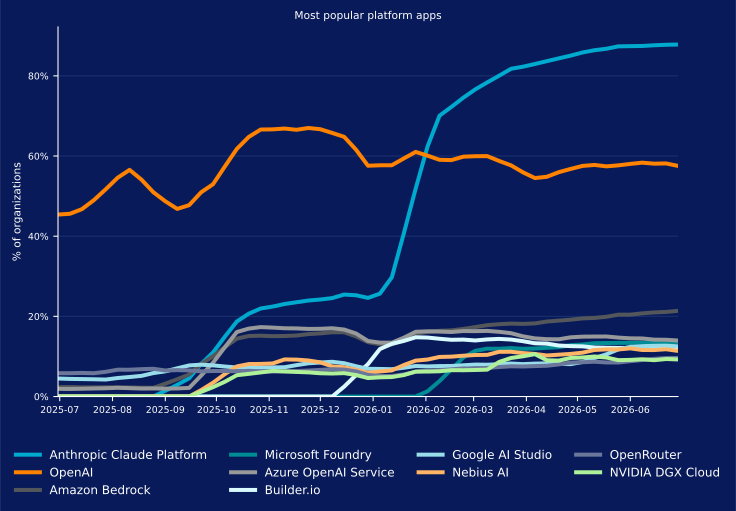
Les plateformes d’IA connaissent également une popularité croissante, avec Claude Platform d’Anthropic en tête. Comme indiqué tout au long de ce rapport, le chatbot Claude d’Anthropic et Claude Code ont rapidement gagné en popularité depuis le début de l’année. Claude Platform, qui permet aux utilisateurs de développer des applications et des agents personnalisés à l’aide de ses modèles, a connu une croissance similaire et a dépassé la plateforme d’OpenAI, autrefois dominante dans ce domaine.
Parallèlement, plusieurs autres plateformes ont enregistré une croissance notable au cours de l’année. Par exemple, loin derrière en troisième position, mais gagnant régulièrement en popularité, se trouve Amazon Bedrock. Parmi les raisons pour lesquelles Bedrock continue de gagner en popularité figurent sa grande variété de modèles et son approche de la souveraineté des données, qui garantit que les données de l’organisation sont isolées, chiffrées, traitées uniquement dans les régions choisies, et qu’elles ne sont jamais partagées avec des tiers ni utilisées pour entraîner des modèles de fondation. Cela étant, certains modèles sont soumis à des conditions spécifiques. Les organisations doivent donc examiner l’utilisation des plateformes, notamment Amazon Bedrock, modèle par modèle. Nous nous attendons néanmoins à observer une poursuite de la migration vers des plateformes telles que Bedrock, à mesure que les organisations accordent la priorité à la souveraineté des données.
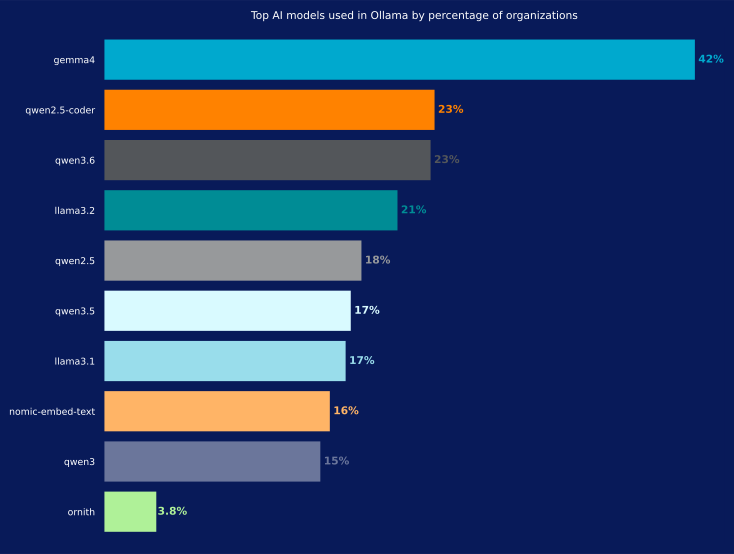
L’exécution locale des modèles devient plus populaire à mesure que les organisations accordent davantage la priorité à la souveraineté des données et cherchent à réduire les coûts liés au cloud. 41 % des organisations — soit davantage que celles qui utilisent Bedrock, mais moins que celles qui utilisent les plateformes OpenAI et Claude — utilisent Ollama. Ce framework open source populaire permet aux organisations de télécharger et d’exécuter des modèles localement. Vous trouverez ci-dessous une répartition de la popularité des modèles, montrant que Gemma4 de Google est de loin le plus populaire, suivi de différentes versions de Qwen d’Alibaba et de Llama de Meta. Nous prévoyons un bouleversement important de ce classement au second semestre, car les modèles GLM de Z.ai se distinguent actuellement dans les benchmarks et gagnent en popularité.
MCP : une interconnexion en hausse rapide
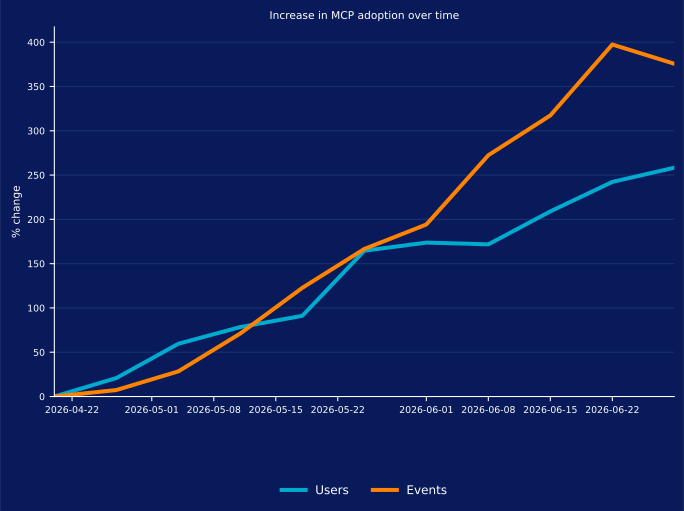
MCP, la norme open source permettant de connecter des modèles d’IA à des sources de données et à des outils externes, a connu une forte hausse de son utilisation, avec une augmentation de 250 % du nombre d’utilisateurs et de 375 % du nombre de transactions au cours des 10 dernières semaines seulement. Cette hausse est significative, car elle entraîne une évolution importante du volume et de la direction des violations de la politique de données, que nous examinons dans la section suivante. En outre, ces statistiques ne représentent que l’utilisation distante de MCP, ce qui signifie que l’agent se connecte à un serveur MCP hébergé sur Internet plutôt que sur la machine locale ou au sein du réseau de son organisation. Parmi les principaux clients utilisés pour se connecter à ces serveurs MCP figurent les agents de codage d’IA Claude Code et Codex mentionnés précédemment dans ce rapport.
Violations de la politique de données : un volume croissant
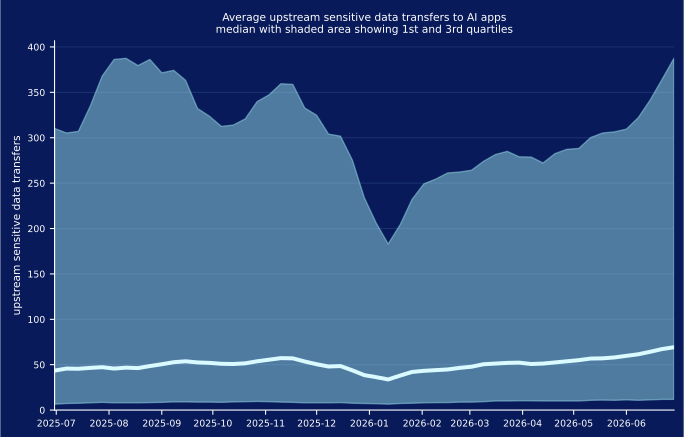
Au cours de l’année écoulée, le nombre de violations de la politique de données en amont a augmenté modérément. L’organisation moyenne en enregistre désormais 69 par semaine, contre 44 par semaine un an auparavant. Dans le même temps, les 25 % d’organisations affichant les niveaux les plus élevés ont connu d’importantes fluctuations au cours de l’année, mais continuent d’enregistrer environ 300 à 400 violations par semaine, soit un niveau similaire à celui observé à la même période l’année précédente.
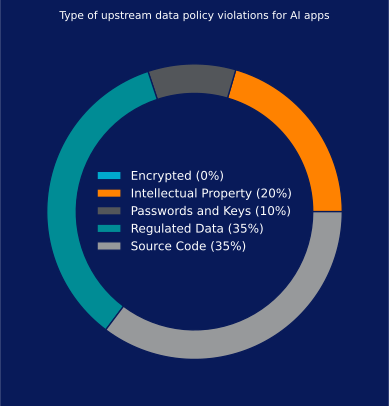
Une ventilation des types de violations montre que la propriété intellectuelle, les données réglementées et le code source représentent la grande majorité des violations de la politique de données, tandis qu’une proportion plus faible concerne des mots de passe et des clés, généralement intégrés dans du code source ou des fichiers de configuration envoyés à des applications d’IA.
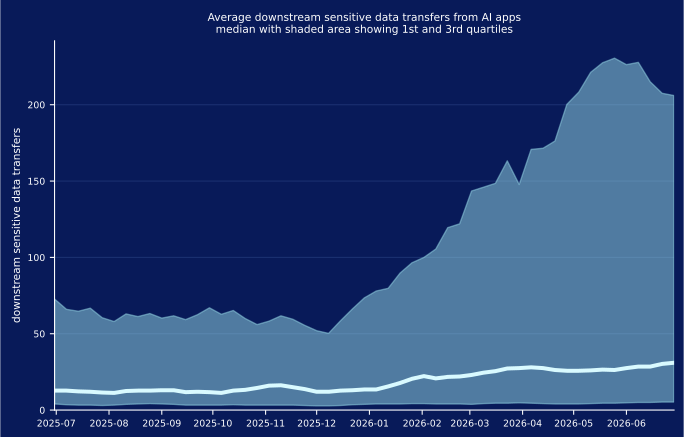
La tendance des violations de la politique de données en aval au cours de l’année écoulée diffère sensiblement de celle des violations en amont. Les violations en aval se produisent moins fréquemment que les violations de la politique de données en amont, mais ont plus que doublé au cours de l’année écoulée, passant de 12 à 31 par semaine. Parmi les 25 % d’organisations affichant les niveaux les plus élevés, ce taux est passé de 72 à 206 par semaine. Cette augmentation intervient parallèlement à la progression de l’adoption de l’IA agentique et de MCP, ainsi qu’à la connexion croissante des applications d’IA à des sources de données et à des outils qui exposent des données sensibles. À mesure que l’adoption de MCP se poursuit, nous prévoyons une hausse généralisée de la proportion de violations de données en aval au cours du second semestre 2026.
Menaces connexes à l’IA
Bien qu’une grande partie de ce rapport porte sur les nouvelles menaces natives de l’IA, qui sont les plus susceptibles de nécessiter de nouveaux contrôles, il reste important de souligner que l’adoption croissante de l’IA s’accompagne également de risques liés à des menaces traditionnelles connexes à l’IA. Dans cette section, nous mettons en évidence deux de ces menaces : les leurres liés à l’IA et les liens liés à l’IA.
Leurres malveillants liés à l’IA
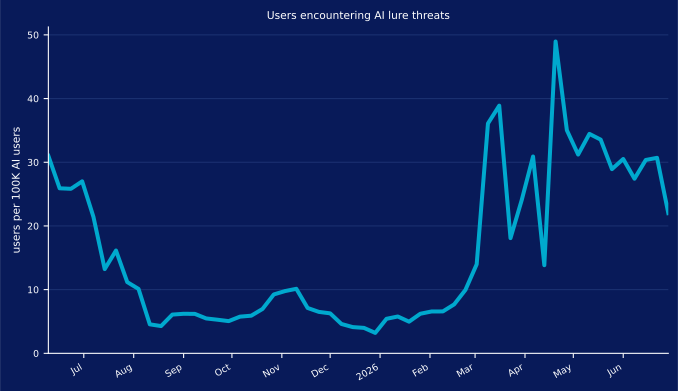
Un leurre malveillant lié à l’IA tente d’inciter des victimes à télécharger un malware ou à consulter un site web malveillant en utilisant une fausse image de marque. Au cours de l’année écoulée, nous avons observé une accalmie de six mois dans le nombre de leurres liés à l’IA, avant une forte hausse en mars, suivie d’un maintien à un niveau similaire jusqu’en juillet. Les campagnes récentes exploitant des leurres liés à l’IA ont notamment utilisé de faux programmes d’installation d’applications d’IA et des outils de développement transformés en chevaux de Troie. Compte tenu de la popularité persistante de l’IA et des pressions exercées sur les organisations pour qu’elles l’exploitent afin d’accroître leur productivité, nous nous attendons à ce que les adversaires continuent de concevoir des appâts sophistiqués liés à l’IA, tels que ces faux programmes d’installation, et trouvent de nouvelles façons de compromettre les pipelines de développement logiciel d’IA, notamment en poursuivant les attaques de type Shai-Hulud et en créant des packages malveillants visant à usurper les noms que les modèles d’IA ont tendance à halluciner.
Liens malveillants liés à l’IA
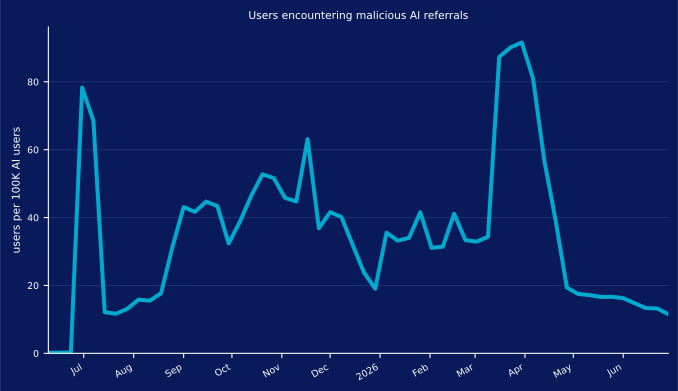
Un lien malveillant lié à l’IA est un lien malveillant renvoyé par une application d’IA sur lequel un utilisateur clique ou auquel un agent accède. Ce phénomène est comparable à un lien malveillant sur lequel les utilisateurs cliquent lorsqu’ils utilisent un moteur de recherche populaire tel que Bing ou Google. Ces liens apparaissent dans les résultats de recherche parce que l’attaquant a utilisé des techniques de SEO pour obtenir un classement élevé de son site malveillant, payé pour qu’une publicité malveillante soit associée aux résultats de recherche ou compromis d’une autre manière une infrastructure légitime. Dans l’univers de l’IA, la technologie a changé, mais les techniques demeurent. L’AIEO émerge à mesure que les techniques permettant de faire traiter favorablement un contenu par les modèles d’IA deviennent bien connues, et les publicités commencent à faire leur apparition dans les applications d’IA. Le volume de ces menaces a considérablement varié au cours de l’année, passant de moins de 10 à plus de 90 par semaine. Nous prévoyons que leur nombre moyen augmentera au second semestre 2026, malgré l’accalmie actuelle.
Visibilité, gouvernance et protection
Pour gérer les risques liés à l’IA, les organisations doivent aligner leurs stratégies de sécurité sur des frameworks largement adoptés tels que MITRE ATLAS et l’OWASP Top 10 for LLMs. Ces frameworks fournissent un contexte essentiel : MITRE ATLAS permet aux CISO de contextualiser les attaques précises détectées et bloquées, tandis que l’OWASP LLM Top 10 clarifie les risques au niveau des applications. En intégrant ces frameworks à une surveillance en temps réel, les équipes de sécurité peuvent suivre efficacement l’application des politiques, détecter les menaces émergentes et obtenir une vue granulaire de leur posture de risque liée à l’IA, notamment avec des ventilations par catégorie de risque et par activité des utilisateurs. En nous appuyant sur cette base stratégique, nous concluons le rapport en transposant les principes de ces frameworks dans une feuille de route tactique centrée sur chacun des risques définis dans ce document. En parcourant ces recommandations propres à chaque risque, vous constaterez plusieurs thèmes récurrents :
- Visibilité : Le déploiement d’une passerelle ou d’un proxy d’IA centralisé est essentiel pour toutes les interactions avec l’IA, notamment l’IA fantôme, l’infrastructure locale et le trafic MCP.
- Gouvernance : Les politiques doivent être alignées sur les risques et granulaires, en intégrant un système matriciel d’approbation des applications et des cas d’utilisation, une gouvernance de la sécurité de la chaîne d’approvisionnement et le respect des exigences régionales, juridiques et de conformité.
- Protection : La posture de sécurité doit être multicouche et utiliser la prévention des pertes de données (DLP) en temps réel, des garde-fous sémantiques non déterministes, une validation heuristique des résultats et une analyse comportementale continue afin de détecter les signes postérieurs à une compromission, par exemple la reconnaissance et le C2.
Ci-dessous, nous avons associé des exigences précises en matière de visibilité, de gouvernance et de protection à chaque risque, afin de fournir un plan opérationnel permettant de les atténuer dans l’ensemble de votre environnement.
Violation de la politique de données (en amont)
- Visibilité : Utilisez une passerelle ou un proxy d’IA pour toutes les interactions avec l’IA, en particulier l’IA fantôme.
- Gouvernance : Définissez une matrice pour les applications et les cas d’utilisation approuvés, en mettant l’accent sur le code source, les données réglementées et la propriété intellectuelle.
- Protection : Configurez des politiques de protection des données en temps réel alignées sur les cas d’utilisation en amont approuvés.
Violation de la politique de données (en aval)
- Visibilité : Utilisez une passerelle ou un proxy d’IA pour toutes les interactions avec l’IA, en particulier MCP.
- Gouvernance : Définissez une matrice des groupes d’utilisateurs et des niveaux d’accès requis aux données sensibles.
- Protection : Configurez des politiques de protection des données en temps réel alignées sur les accès approuvés aux données en aval.
Filtrage du contenu
- Visibilité : Utilisez une passerelle ou un proxy d’IA pour toutes les interactions avec l’IA, en particulier l’IA fantôme.
- Gouvernance : Alignez l’analyse de texte en temps réel sur les politiques de ressources humaines de l’entreprise, les critères de conformité juridique et les politiques régionales d’utilisation acceptable (AUP).
- Protection : Exploitez des garde-fous d’IA dotés d’une connaissance contextuelle et d’un filtrage par mots-clés.
Injection d’invites et jailbreaking
- Visibilité : Utilisez une passerelle ou un proxy d’IA pour toutes les interactions avec l’IA, y compris l’infrastructure locale.
- Gouvernance : Exigez que toute infrastructure d’IA soit examinée avant son déploiement afin de garantir une isolation optimale et qu’elle intègre des garde-fous.
- Protection : Déployez des garde-fous sémantiques non déterministes, associés à une analyse comportementale, afin de détecter même les tentatives les plus subtiles d’injection d’invites et de jailbreaking, puis superposez à ces contrôles des politiques de protection des données et une inspection du code malveillant.
Demandes de données sensibles
- Visibilité : Utilisez une passerelle ou un proxy d’IA pour toutes les interactions avec l’IA, avec une journalisation d’audit de toutes les invites.
- Gouvernance : Établissez des frameworks de responsabilité et d’isolation afin de limiter les ressources interconnectées.
- Protection : Déployez des garde-fous sémantiques non déterministes, associés à des politiques de protection des données et à une analyse comportementale, afin de détecter les tentatives adverses d’accès aux données sensibles.
Piratage et droits d’auteur
- Visibilité : Utilisez une passerelle ou un proxy d’IA pour toutes les interactions avec l’IA, inspectant l’ensemble du contenu en aval.
- Gouvernance : Rédigez des directives formelles de conformité en matière de propriété intellectuelle précisant quels modèles et quelles applications d’IA peuvent être utilisés pour générer du code, des contenus textuels et d’autres contenus sensibles.
- Protection : Intégrez aux réponses de l’IA des vérifications heuristiques de validation des résultats qui comparent le code source ou les textes générés aux signatures open source et aux index de marques connus. Définissez des politiques visant à limiter les cas d’utilisation non approuvés, par exemple en empêchant l’utilisation de certains modèles pour générer du code source.
Code malveillant
- Visibilité : Utilisez une passerelle ou un proxy d’IA pour toutes les interactions avec l’IA, inspectant l’ensemble du contenu en aval.
- Gouvernance : Imposez une architecture de validation zéro confiance dans tous les pipelines CI/CD internes, avec une gouvernance robuste des risques liés à la chaîne d’approvisionnement.
- Protection : Outre la protection contre l’injection d’invites, veillez à ce que toutes les réponses des applications d’IA soient inspectées afin de détecter le code malveillant, intégrez l’analyse des menaces à vos pipelines CI/CD et utilisez l’analyse comportementale pour détecter les signes postérieurs à une compromission, notamment la reconnaissance, le C2 et l’exfiltration de données.
À propos de ce rapport
Les informations présentées dans ce rapport reposent sur des données agrégées d’utilisation collectées par la plateforme Netskope One auprès d’un sous-ensemble de clients Netskope entre juin 2025 et juillet 2026.